
به گزارش دانشمند، مدلهای هوش مصنوعی در سال ۲۰۲۵ به سرعت بهبود یافتند و نمرات معیارها در حوزههای زبان، استدلال، کدنویسی و ریاضی افزایش یافت. با این حال، ارزیابیها از پیشرفتی که برای اندازهگیری آنها ساخته شده بودند، پیشی میگیرند و معیارها با سؤالات فزایندهای در مورد قابلیت اطمینان خود روبهرو هستند. حتی با وجود این محدودیتها، یک الگوی واضح پدیدار میشود: شکاف بین مدلهای برتر در حال کاهش است. این کاهش از نظر جغرافیایی گسترش مییابد، زیرا فاصله بین مدلهای برتر ایالات متحده و چین تقریباً بهطور کامل بسته شده است. با توجه به اینکه توانایی دیگر یک عامل تمایز آشکار نیست، فشار رقابتی به سمت هزینه، قابلیت اطمینان و سودمندی در دنیای واقعی تغییر میکند. در حوزههای حرفهای، ارزیابیها در حوزههای مالیات، استدلال حقوقی و امور مالی شرکتها در برخی زمینهها عملکرد قویتری نسبت به سایر حوزهها نشان میدهند.
دامنه کارهایی که سیستمهای هوش مصنوعی میتوانند انجام دهند نیز در حال گسترش است. عوامل هوش مصنوعی در حال بهبود هستند، اما هنوز تقریباً از هر ۳ تلاش، یک تلاش شکست میخورد.
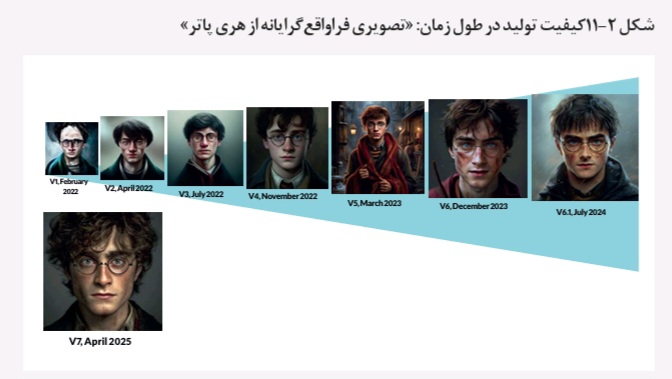
مدلهای تولید ویدئو دیگر فقط محتوای واقعگرایانه تولید نمیکنند؛ برخی شروع به یادگیری نحوه عملکرد دنیای فیزیکی کردهاند، پیشرفتی که میتواند به ورود هوش مصنوعی به فضاهای فیزیکی کمک کند. اینگذار هنوز در مراحل اولیه است، زیرا رباتها در محیطهای بدون ساختار با مشکل مواجه هستند، اگرچه وسایل نقلیه خودران یک استثنای قابلتوجه هستند که به استقرار در مقیاس انبوه با سوابق ایمنی اولیه امیدوارکننده رسیدهاند. در مجموع، پیشرفت فنی هوش مصنوعی داستانی از شگفتی و سرعت است، سریعتر از بسیاری از چارچوبهای ارزیابی، حاکمیت و پذیرش که در بخشهای بعدی مورد بررسی قرار گرفتهاند.
نکات برجسته:
۱. توانایی هوش مصنوعی از معیارهای طراحیشده برای اندازهگیری آن و از عملکرد در سطح انسان پیشی گرفته است. مدلهای Frontier در آخرین آزمون Humanity، که برای ارزیابی سخت بودن برای هوش مصنوعی و مطلوب بودن برای متخصصان انسانی ساخته شده است، در یک سال ۳۰ درصد امتیاز کسب کردند. ارزیابیهایی که قرار بود سالها چالشبرانگیز باشند، در ماهها اشباع شدهاند و این امر، بازه زمانی مفید بودن معیارها برای ردیابی پیشرفت را کاهش میدهد.
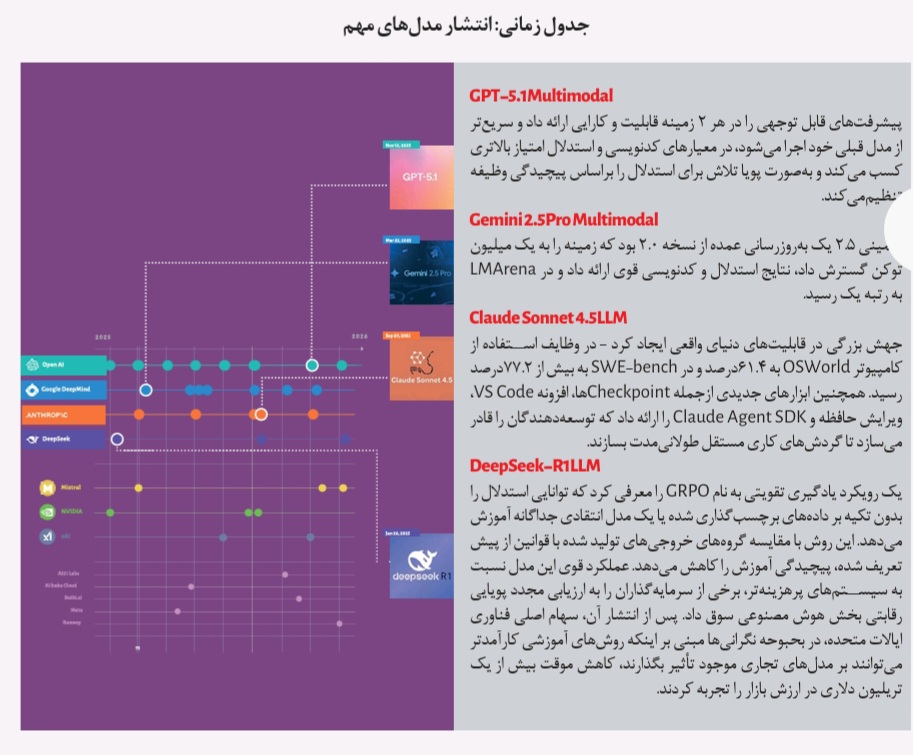
۲. عملکرد مدلهای برتر در حال همگرایی است. از مارس ۲۰۲۶، آنتروپیک (۱۵۰۳)، xAI (1495)، گوگل (۱۴۹۴)، OpenAI (1481)، علیبابا (۱۴۴۹) و DeepSeek (1424) همگی در رتبههای برتر رتبهبندی Arena Elo قرار دارند و فشار رقابتی را به سمت هزینه، قابلیت اطمینان و عملکرد خاص دامنه تغییر میدهند.
۳. شکاف عملکرد مدل هوش مصنوعی ایالات متحده و چین عملاً از بین رفته است. مدلهای آمریکایی و چینی از اوایل سال ۲۰۲۵ چندین بار جایگاه خود را در صدر رتبهبندی عملکرد جابهجا کردهاند. در فوریه ۲۰۲۵، DeepSeek-R1برای مدت کوتاهی با مدل برتر ایالات متحده برابری کرد. از مارس ۲۰۲۶، مدل برتر ایالات متحده با ۲.۷درصد اختلاف پیشتاز است، با این تفاوت که این اختلاف در طول سال گذشته نوسان داشته است، درحالیکه در عدد تک رقمی باقی مانده است.
۴. مدلهای تولید ویدئو شروع به ثبت نحوه رفتار اشیاء کردهاند. مدل Veo 3گوگل دیپمایند، که در بیش از ۱۸۰۰۰ ویدئوی تولیدشده آزمایش شد، تواناییهایی مانند شبیهسازی شناوری و حل ماز را بدون آموزش در مورد آن وظایف نشان داد.
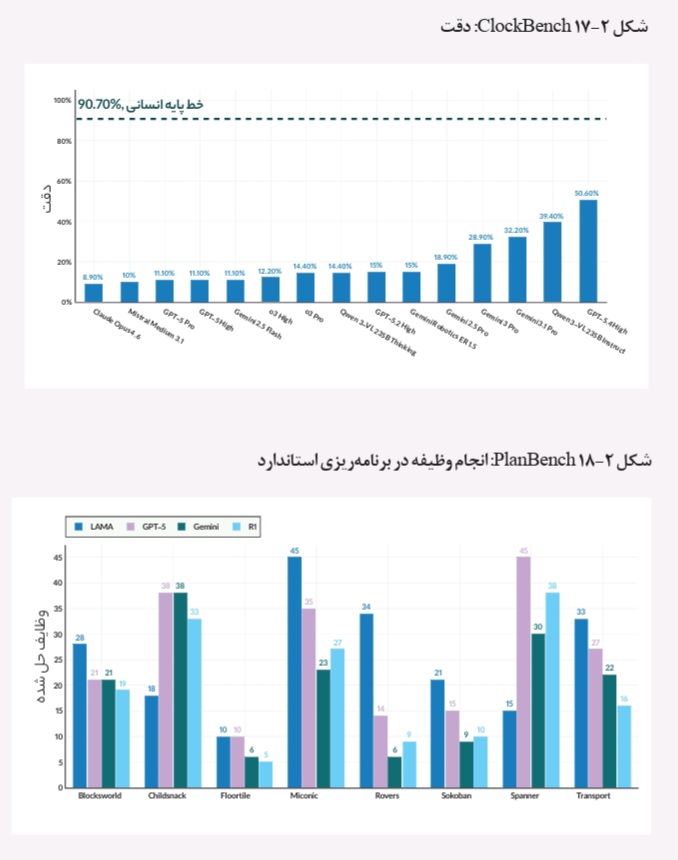
۵. مدلهای هوش مصنوعی میتوانند در المپیاد بینالمللی ریاضی مدال طلا کسب کنند، اما هنوز نمیتوانند زمان را بهطور قابل اعتمادی تشخیص دهند، که نشاندهنده چیزی است که محققان آن را هوش ناهموار مینامند. Gemini Deep Think در IMO 2025، ۳۵ امتیاز (طلا) کسب کرد و در زبان طبیعی در محدوده زمانی ۴.۵ ساعت، از ابتدا تا انتها کار کرد، که نسبت به امتیاز نقره ۲۸ امتیازی که در سال ۲۰۲۴ بهدست آمد، افزایش یافته است. در ClockBench، مدل برتر ساعتهای آنالوگ را ۵۰.۱درصد مواقع به درستی خواند، درحالیکه این رقم برای انسانها ۹۰.۱درصد بود.
۶. مدلهای هوش مصنوعی در حال گسترش به حوزههای حرفهای هستند و عملکردی از ۶۰ تا ۹۰درصد را در ارزیابیهای مربوط به مالیات، پردازش وام مسکن، امور مالی شرکتها و استدلال حقوقی نشان میدهند. عملکرد ۱۵ مدل برتر در هر معیار، تنها ۳ درصد با هم تفاوت دارد. این نوع حوزهها که در آنها به شایستگی و قابلیت اطمینان بالا نیاز است، همچنان چالش بزرگی برای مدلهای هوش مصنوعی هستند.
۷. عاملهای هوش مصنوعی در سال ۲۰۲۵ از پاسخ دادن به سؤالات به انجام وظایف پیشرفت کردند، اگرچه هنوز هم در معیارهای ساختاریافته تقریباً از هر ۳ تلاش، یکبار شکست میخورند. در OSWorld، که عاملها را در وظایف واقعی کامپیوتر در سیستمعاملهای مختلف آزمایش میکند، دقت از تقریباً ۱۲درصد به ۶۶.۳درصد افزایش یافته است، که در ۶ درصد عملکرد انسان قرار دارد.
۸. رباتها هنوز در انجام اکثر کارهای خانه شکست میخورند، حتی اگر در محیطهای کنترلشده عالی باشند. رباتها تنها در ۱۲درصد از کارهای واقعی خانه موفق میشوند، که نشان میدهد هوش مصنوعی تا تسلط بر دنیای فیزیکی چقدر فاصله دارد.
۹. وسایل نقلیه خودران در سال ۲۰۲۵ به استقرار در مقیاس انبوه رسیدند. Waymo تقریباً به ۴۵۰،۰۰۰ سفر هفتگی در ۵ شهر ایالات متحده رسید. در چین، آپولو گو ۱۱ میلیون سفر کاملاً بدون راننده را به پایان رساند که افزایشی ۱۷۵ درصدی نسبت به سال گذشته را نشان میدهد. اپراتورهای اروپایی فعال هستند، اما دادههای استقرار قابل مقایسه در دسترس عموم نیست و تصویر جهانی را محدود میکند. تاکنون استقرارها در مناطقی با آب و هوای عموماً مساعد انجام شده است.
۲-۱روندهای کلی عملکرد
این بخش الگوهای عملکرد هوش مصنوعی را بررسی میکند، از سرعت رسیدن مدلها به سطوح پایه انسانی گرفته تا چگونگی کاهش رقابت بین مدلها و کشورهای پیشرو. همچنین ارزیابی میکند که ابزارهای مورد استفاده برای اندازهگیری این پیشرفت، خود در چه مواردی دچار نقص هستند.
۲-۱-۱معیارهای عملکرد فنی در مقابل عملکرد انسان
عملکرد هوش مصنوعی در سال ۲۰۲۵طیف وسیعی از دستههای معیار به بهبود خود ادامه داد و برخی از بزرگترین دستاوردها در وظایفی ظاهر شدند که تنها چند سال پیش بسیار پایینتر از عملکرد پایه انسان بودند (شکل ۲-۱).
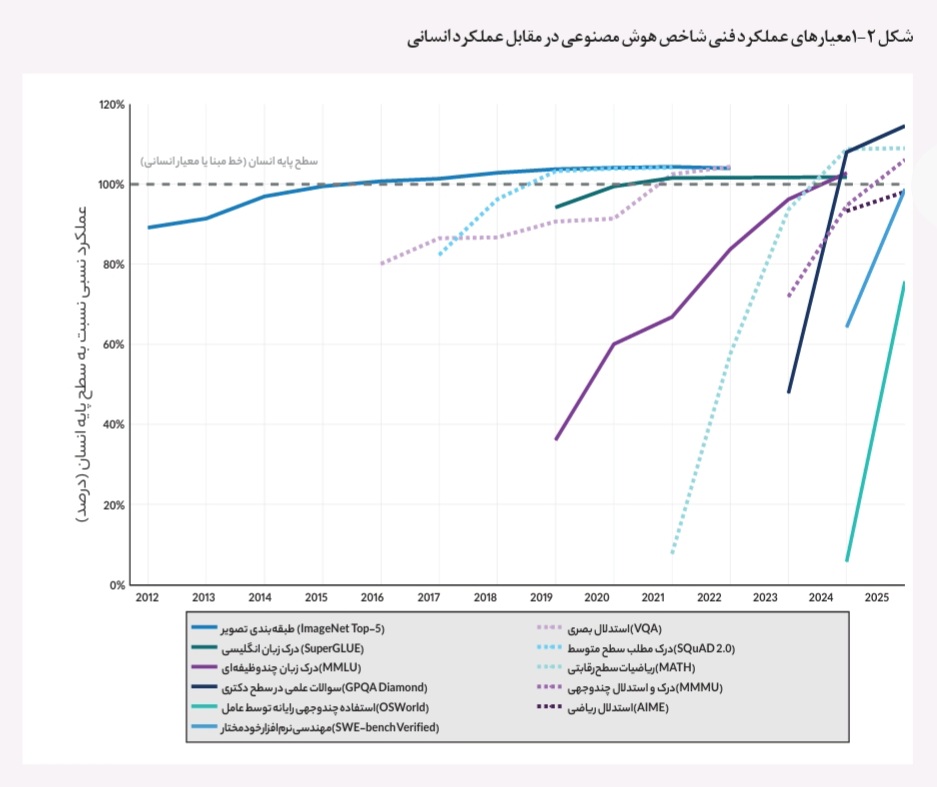 سیستمهای Frontier اکنون به سطوح عملکرد تعیینشده انسان در معیارهای بلندمدت، ازجمله ImageNet، SuperGLUE و MMLU، رسیدهاند یا از آنها فراتر رفتهاند. چندین معیار که برای آزمایش استدلال پیشرفتهتر طراحی شدهاند، به معیار انسانی رسیدهاند یا به آن نزدیک شدهاند، ازجمله سؤالات علمی سطح دکتری (GPQA Diamond)، استدلال چندوجهی (MMMU) و استدلال ریاضی (AIME). مدلها هنوز در زمینههای مهندسی نرمافزار خودکار (SWE-bench Verified) و استفاده از رایانه چندوجهی مبتنی بر عامل (OSWorld) پایینتر از حد پایه عمل میکنند، اما سرعت بهبود
به سرعت در حال افزایش است. برای مثال در SWE-bench Verified، عملکرد از تقریباً ۶۰درصد در سال ۲۰۲۴ به نزدیک ۱۰۰درصد در سال ۲۰۲۵ افزایش یافته است.
۲-۱-۲مدلهای وزن بسته در مقابل مدلهای وزن باز
شکاف عملکرد بین مدلهای وزن بسته پیشرو و مدلهای وزن باز در طول ۳ سال گذشته نوسان داشته است، بهطوری که سیستمهای وزن باز با عرضه مدلهای اختصاصی جدید، فاصله خود را کم کرده و سپس عقب میافتند (شکل ۲-۲). در ماه مه ۲۰۲۳، مدل وزن بسته پیشرو
(GPT-4-0314) با ۱۷۴امتیاز (۱۵.۲درصد) از مدل وزن باز برتر (Vicuna-13B) در جدول امتیازات آرنا پیشی گرفت.
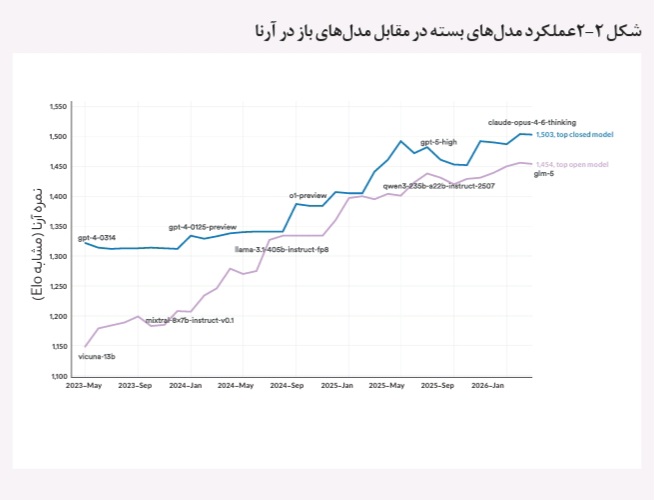
مدلهای وزن باز قویتر، ازجمله Mixtral، WizardLM و Llama-3.1-405B، این شکاف را تا اوت ۲۰۲۴به تنها ۷امتیاز (۰.۵درصد) کاهش دادند. در طول سال گذشته، این روند با ورود سیستمهای مرزی وزن بسته جدید مانند o1-preview و Gemini 2.5Pro معکوس شد. از مارس ۲۰۲۶، مدل برتر وزن بسته، Claude Opus 4.6 (1، ۵۰۳)، با ۴۹امتیاز (۳.۴درصد) از مدل برتر وزن باز GLM-5(1، ۴۵۴) پیشی گرفت. درحالیکه مدلهای وزن بسته هنوز پیشتاز هستند، مدلهای وزن باز بسیار رقابتیتر از چند سال پیش هستند.
۲-۱-۳عملکرد فنی ایالات متحده در مقابل چین
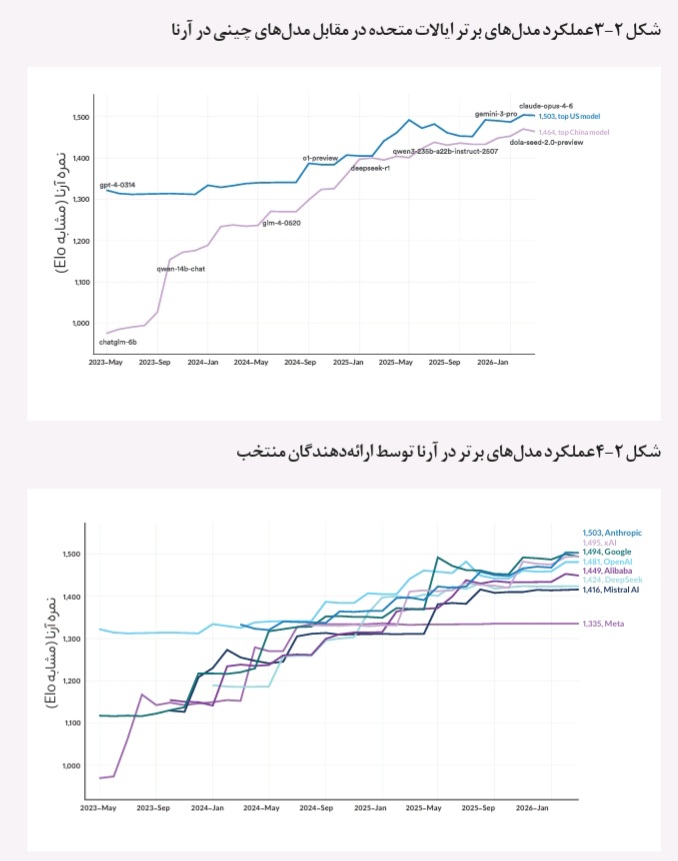
پیشی قابلتوجه ایالات متحده در سال ۲۰۲۳ تا اوایل ۲۰۲۵ بهطور چشمگیری کاهش یافت و شکاف عملکرد از آن زمان تاکنون باریک مانده است (شکل ۲-۳). در فوریه ۲۰۲۵، DeepSeek-R1(۱۴۰۰) تنها با ۵ امتیاز آرنا (۰.۴درصد) از مدل پیشرو ایالات متحده o1-2024-12-17(1405) عقب ماند. تا مارس ۲۰۲۶، مدل برتر ایالات متحده Claude Opus 4.6(1503) با ۳۹ امتیاز (۲.۷درصد) از مدل برتر چینی Dola-Seed-2.0Preview (1464) پیشی گرفت. در طول سال گذشته، این شکاف بین تقریباً برابر و تکرقمیهای پایین در نوسان بوده است. این همگرایی بهویژه قابلتوجه است زیرا از ۲ محیط توسعه و زمینههای نهادی متمایز، ازجمله پویاییهای تحقیقاتی بررسی شده در بخش ۱و الگوهای سرمایهگذاری مورد بحث در بخش ۴، پدید آمده است.
۲-۱-۴عملکرد مدلهای مرزی
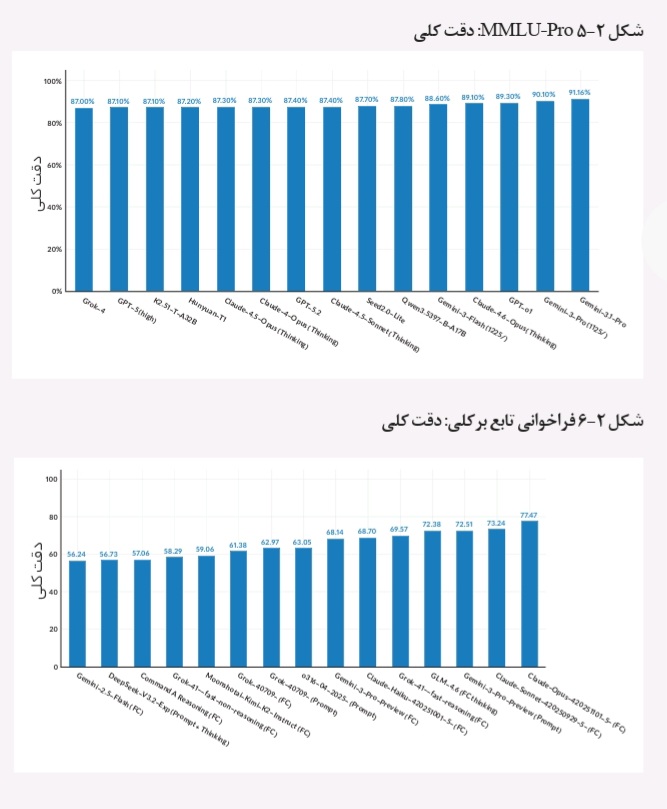
مدلهای مرزی در طول سال گذشته، با انتقال چندین شرکت به یک گروه عملکردی بسیار باریک در بالای جدول امتیازات Arena (شکل ۲-۴)، خوشهبندی فشردهتری پیدا کردند. در اوایل سال ۲۰۲۳، OpenAI با امتیاز ۱۳۲۲در مقایسه با ۱۱۱۷گوگل، پیشتازی آشکاری داشت. این شکاف تا سال ۲۰۲۴بهطور پیوسته کاهش یافت، زیرا گوگل، Anthropic و دیگران مدلهای قویتری را منتشر کردند. تا فوریه ۲۰۲۵، DeepSeek برای مدت کوتاهی با سیستمهای برتر ایالات متحده در Arena برابری کرده و از آنها پیشی گرفت. در گزارش سال گذشته، ۴ مدل برتر تقریباً ۹۷امتیاز کسب کردند و تا مارس ۲۰۲۶، چهار مدل برتر با کمتر از ۲۵امتیاز از هم جدا شدهاند. Anthropic با امتیاز ۱۵۰۳پیشتاز است و پس از آن xAI (1495)، گوگل (۱۴۹۴) و OpenAI (1481) قرار دارند. DeepSeek (1، ۴۲۴) و Alibaba (1، ۴۴۹) تنها اندکی عقبتر هستند. عملکرد Meta’s Arena از اوایل سال ۲۰۲۵ثابت مانده است، که نشاندهنده کاهش سرعت عرضه محصولات رقابتی است، اگرچه مدلهای جدیدتر میتوانند برای سال ۲۰۲۶در راه باشند. از آنجایی که تشخیص مدلهای پیشرو در عملکرد معیار دشوارتر میشود، عواملی مانند هزینه، تأخیر، قابلیت اطمینان و بهینهسازی خاص دامنه ممکن است نقش بیشتری در پذیرش کاربر داشته باشند.
۲-۲زبان
درک و تولید زبان همچنان بهعنوان قابلیتهای بنیادی برای سیستمهای هوش مصنوعی مدرن عمل میکنند. این بخش به بررسی نحوه عملکرد مدلها در وظایفی که نیاز به درک متن پیچیده، تولید پاسخهای منسجم و اجرای عملیات تخصصی مبتنی بر زبان دارند، میپردازد. این معیارها همچنین از پاسخ به سؤالات عمومی تا قابلیتهای فنی خاص مانند فراخوانی تابع و جاسازی متن را در بر میگیرند. معیارهای درک زبان، میزان توانایی مدلها در درک و استدلال متن طیف وسیعی از موضوعات، از علوم انسانی گرفته تا مطالب بسیار فنی را اندازهگیری میکنند.
۲-۲-۱ MMLU: درک گسترده زبان چندوظیفهای
MMLU همچنان یک معیار پرکاربرد برای سنجش دانش گسترده در رشتههای مختلف است. معیار MMLU-Pro که در سال ۲۰۲۴معرفی شد، عملکرد را با بیش از ۱۲۰۰۰سؤال و یک قالب ۱۰گزینهای و چندگزینهای که برای آزمون بهتر استدلال طراحی شده است، ارزیابی میکند. در مقایسه با معیار اصلی MMLU، دقت مدل در MMLU-Pro معمولاً ۱۶تا ۳۳درصد کاهش مییابد که تمایز بهتری بین مدلهای برتر ایجاد میکند. بهعنوان مثال، بهنظر میرسد GPT-4o و GPT-4-Turbo در MMLU استاندارد یک درصد اختلاف دارند، اما در MMLU-Pro این اختلاف به ۹درصد افزایش مییابد.
طراحی معیار جدیدتر، حساسیت به پاسخ را کاهش داده و ارزیابی استدلال را تقویت میکند. پیش از این، MMLU حدود ۴تا ۵درصد حساسیت به تغییرات پاسخ را نشان میداد، درحالیکه این مقدار برای MMLU-Pro حدود ۲درصد تخمین زده میشد. علاوه بر این، روشهای استدلال مانند زنجیره فکری، عملکرد بسیار بهتری در MMLU-Pro نسبت به استراتژیهای پاسخ مستقیم دارند.
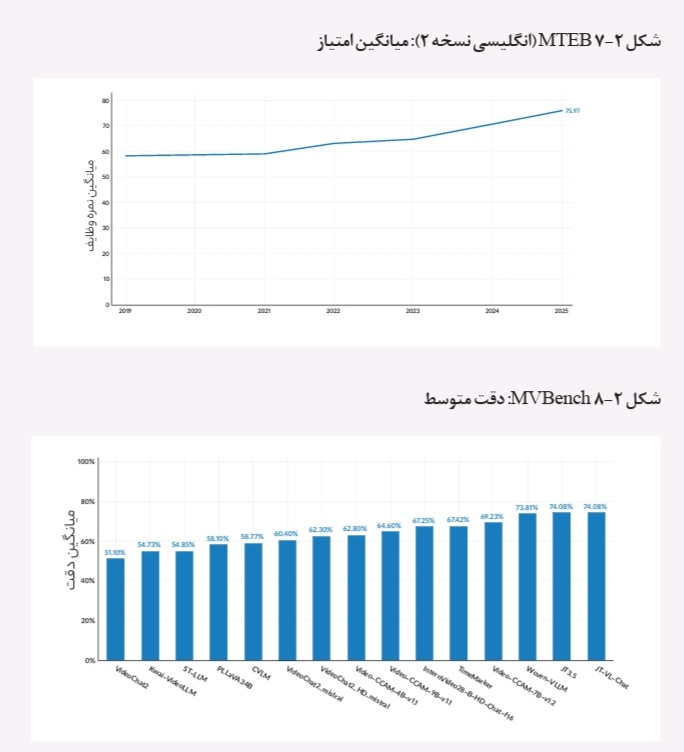
از اوایل سال ۲۰۲۶، عملکرد مدلهای برتر در MMLU-Pro بهشدت خوشهای است، بهطوری که ۱۵مدل برتر همگی امتیاز بالای ۸۷درصد کسب کردهاند (شکل ۲-۵). Google’s Gemini-3.1-Pro با ۹۱.۲درصد در صدر قرار دارد و پس از آن Gemini-3-Pro با ۹۰.۱درصد و GPT-o1با ۸۹.۳درصد قرار دارند. مدلهایی که از استراتژیهای تفکر استفاده میکنند، در رتبهبندیها بالاتر ظاهر میشوند و از همتایان استاندارد خود که در محدوده ۸۷درصد تا ۸۸درصد گروهبندی شدهاند، عملکرد بهتری دارند. اختلاف کلی بین مدل برتر و مدل پانزدهم کمی بیش از ۴درصد است که نشان میدهد مرز رقابت در وظایف دانش گسترده چقدر رقابتی شده است.
۲-۲-۲جدول امتیازات فراخوانی تابع برکلی
فراخوانی تابع به یک مدل اجازه میدهد تا با تولید درخواستهای ساختاریافتهای که سیستم دیگری میتواند اجرا کند، از ابزارها و APIهای خارجی استفاده کند و سپس نتایج را به پاسخ خود تبدیل کند. این یک قابلیت اساسی برای چارچوبهای عامل است، جایی که مدلها نیاز به انجام اقدامات یا بازیابی اطلاعات فراتر از دادههای آموزشی خود دارند. جدول امتیازات فراخوانی تابع برکلی (BFCL) مدلها را براساس توانایی فراخوانی تابع آنها ارزیابی میکند و از زمان انتشار اولیه خود بهطور قابلتوجهی تکامل یافته است. نسخه فعلی، BFCL V4، تمرکز را به سمت ارزیابیهای جامع عامل تغییر میدهد. مؤلفه عامل، جستوجوی وب و حافظه را آزمایش میکند درحالیکه مؤلفه چند نوبتی دیالوگهای چند مرحلهای را ارزیابی میکند. نسخههای قبلی بهطور محدودتری بر فراخوانی تابع تک نوبتی تمرکز داشتند. دقت کلی در BFCL از اوایل سال ۲۰۲۶بسیار متفاوت است. ۱۵مدل برتر تقریباً در محدوده ۲۱درصد قرار دارند (شکل ۲-۶). مدلهای Claude 3 مورد از ۶ موقعیت برتر را اشغال میکنند، که Claude Opus-4.5با ۷۷.۵درصد در صدر قرار دارد.
۲-۲-۳ MTEB: معیار جاسازی متن انبوه
معیار جاسازی متن انبوه (MTEB) مدلهای مختلف جاسازی را در مجموعهای از وظایف که نیاز به درک معنایی دارند، ارزیابی میکند. این معیار شامل بیش از ۵۰مجموعه داده است که ۸ دسته وظیفه را در بر میگیرد و این امر باعث میشود مدلها با بهینهسازی برای یک مورد استفاده واحد به جای عملکرد خوب در تنظیمات مختلف، قوی بهنظر نرسند. بالاترین امتیاز میانگین وظیفه در MTEB (نسخه انگلیسی ۲) از سال ۲۰۲۲بهطور پیوسته افزایش یافته است، که همزمان با پذیرش گستردهتر تکنیکهای پیشآموزش در مقیاس بزرگ برای مدلهای جاسازی است. در سال ۲۰۲۵، بالاترین امتیاز به ۷۶رسید که از سال ۲۰۲۳تقریباً ۱۱امتیاز افزایش یافته است (شکل ۲-۷). با این حال، بهترین مدلها هنوز به امتیاز کامل نمیرسند.
۲-۳تصویر و ویدئو
فراتر از زبان، بسیاری از مدلها ورودیهای بصری را پردازش میکنند و قابلیتهای ویدئویی و تصویری آنها بهطور قابلتوجهی پیشرفت کرده است. این بخش عملکرد مدل را در ابعاد درک – اینکه چقدر خوب محتوای ویدئویی را درک و استدلال میکنند – و تولید، که کیفیت تصاویر و ویدئوهای تولید شده توسط هوش مصنوعی را ارزیابی میکند، بررسی میکند.
۲-۳-۱درک
معیارهای درک ویدئو، میزان توانایی مدلها در ردیابی اعمال، اشیاء و رویدادها در فریمها را به جای استدلال در یک تصویر واحد، اندازهگیری میکنند. با بهبود عملکرد در معیارهای قبلی، ارزیابی به سمت وظایفی تغییر کرده است که نیاز به استدلال زمانی چند مرحلهای و دانش خاص دامنه اعمال شده به ویدئو دارند.
MVBench: ارزیابی میکند که آیا مدلهای چندوجهی میتوانند فراتر از درک تصویر ایستا حرکت کنند تا پیچیدگیهای ویدئو را مدیریت کنند. این شامل تفسیر حرکت، توالیهای زمانی و تغییر زمینه در فریمها میشود. تمرکز آن بر استدلال زمانی، آن را به یک معیار مفید برای ردیابی عملکرد در محیطهای بصری پویاتر تبدیل میکند. مدل برتر در MVBench به میانگین دقت ۷۴.۱درصد میرسد، و JT-VL-Chat و JT3.5در این امتیاز مشترک هستند (شکل ۲-۸). در اوایل سال ۲۰۲۶، در بین ۱۵مدل برتر، عملکرد در محدوده تقریباً ۲۳درصد قرار دارد.
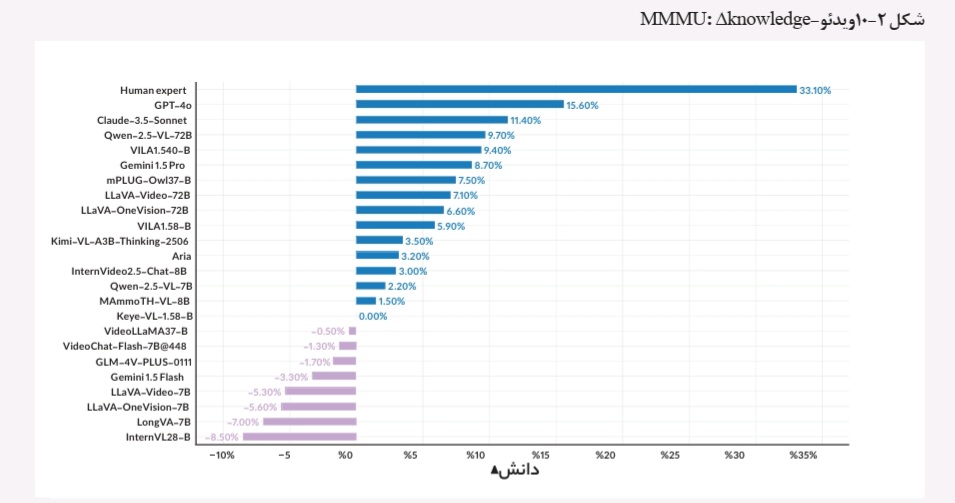
Video-MMMU: یک معیار بزرگ، چندوجهی و چندرشتهای برای یادگیری از طریق ویدئوهای آموزشی است که شامل ۳۰۰ ویدئوی سطح تخصصی با میانگین تقریباً ۵۰۶ ثانیه در ۶ رشته و ۳۰ موضوع است. هر ویدئو با ۳ مجموعه سؤال جفت میشود که درک عمیقتر را میسنجند. سؤالات ادراکی بررسی میکنند که آیا یک مدل میتواند جزئیات کلیدی را از متن/صوت استخراج کند یا خیر؛ سؤالات درک مطلب بررسی میکنند که آیا مفهوم یا استراتژی راهحل را درک میکند یا خیر؛ و سؤالات انطباق نیاز به اعمال آن دانش در یک سناریوی جدید دارند. سؤالات انطباق از موارد MMMU/MMMU-Pro برای زمینههای STEM و مطالعات موردی سفارشی برای هنر/علوم انسانی استفاده مجدد میکنند، بنابراین مدلها باید فراتر از ویدئوی خاص باشند. این معیارها همچنین یک معیار Δknowledge را برای ردیابی میزان بهبود عملکرد یک مدل پس از پردازش ویدئو معرفی میکنند.
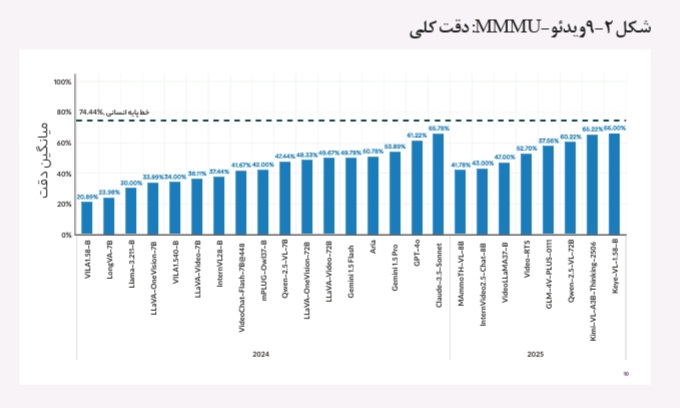
تا سال ۲۰۲۵، هیچ مدلی در دقت کلی Video-MMMU به سطح پایه انسانی ۷۴.۴درصد نرسیده است. (شکل ۲-۹) بهترین مدل، Keye-VL-1.5-8B، امتیاز ۶۶درصد را کسب میکند و پس از آن Claude -3.5-Sonnet
(65.8درصد) قرار دارد. کمترین امتیاز VILA1.5-8B با ۲۰.۹درصد است که در جدول امتیازات، اختلاف ۴۵درصدی را نشان میدهد.
نتایج معیار Δknowledge، شکاف بیشتری را بین یادگیری انسان و مدل نشان میدهد (شکل ۲-۱۰). متخصصان انسانی پس از تماشای ویدئو، ۳۳.۱درصد امتیاز کسب میکنند، درحالیکه بهترین مدل در این معیار، GPT-4o، تنها حدود نیمی از آن (۱۵.۶امتیاز) را بهدست میآورد. حدود یک سوم مدلها حتی Δknowledge منفی نشان میدهند، زیرا عملکرد آنها پس از پردازش ویدئو در واقع کاهش مییابد.
۲-۳-۲تولید
درحالیکه معیارهای فوق، میزان تفسیر محتوای بصری موجود توسط مدلها را آزمایش میکنند، معیارهای تولید، میزان توانایی مدلها در تولید آن را ارزیابی میکنند. ارزیابی، هم رتبهبندی ترجیحات انسانی و هم معیارهای کیفیت خودکار را در بر میگیرد، زیرا ویدئوی تولیدشده باید انتظارات ذهنی و معیارهای فنی مانند انسجام، وفاداری و قابلیت کنترل را برآورده کند. از این میان، قابلیت کنترل به یک تمرکز بسیار مهم تبدیل شده است که نشان میدهد آیا مدلها میتوانند ضمن حفظ حرکت طبیعی و پویایی صحنه، قصد کاربر را دنبال کنند یا خیر. این امر همچنین تولید ویدئو را به ایده مدلهای جهانی نزدیکتر کرده است، جایی که سیستمها قصد دارند پیشبینی کنند که صحنههای بصری چگونه در طول زمان تکامل مییابند.
۲-۴استدلال
معیارهای استدلال، ارزیابی میکنند که آیا مدلها میتوانند مسائلی را که نیاز به انتزاع و تعمیم در حوزهها و قالبهای مختلف دارند، حل کنند یا خیر. در میان معیارهای این بخش، مدلهای پیشرو در بسیاری از وظایف عملکرد خوبی دارند، اما هنوز در موارد دشوارتر، شکافهایی را نشان میدهند.
۲-۴-۱استدلال عمومی
استدلال عمومی به توانایی یک مدل در حل مسائل ناآشنا با اعمال قوانین و ترکیب شواهد، به جای تکیه بر دانش حوزه یا الگوهای حفظ شده، اشاره دارد. معیارهای مورد بحث در زیر، حوزهها و وظایف متعددی را در بر میگیرند و برای آزمایش استنتاج چند مرحلهای طراحی شدهاند. یک مثال، حساب چند رقمی، مانند ضرب اعداد صحیح طولانی، برای آزمایش این است که آیا مدلها میتوانند محاسبات گام به گام ثابتی را اجرا کنند یا خیر، نه اینکه خروجیهای قابلقبول تولید کنند. سایر معیارهای پیچیدهتر، این ایده را به تنظیمات چندوجهی گسترش میدهند، جایی که مدلها باید متن را با نمودارها یا نقشهها ادغام کنند تا به پاسخ صحیح برسند.
MMMU: استدلال چندوجهی را در سؤالات موضوعی سطح دانشگاه که متن را با تصاویر مانند نمودارها، چارتها، جداول و معادلات ترکیب میکنند، ارزیابی میکند. برخی از وظایف نمونه شامل استخراج محدودیتها از یک جدول و اعمال آنها به یک مسئله کلامی یا استفاده از یک نمودار برای پاسخ به یک سؤال خاص در حوزههایی مانند مهندسی یا پزشکی است. از فوریه ۲۰۲۶، مدل پیشرو Gemini 3.1Pro Preview، در MMMU امتیاز ۸۸.۲درصد و در محدوده ۰.۴درصد از بهترین مرجع متخصص انسانی (شکل ۲-۱۲) کسب کرد. سایر انواع Gemini با فاصله کمی در رتبههای بعدی قرار دارند، درحالیکه GPT-5.2امتیاز ۸۶.۷درصد را کسب کرده است.
آخرین آزمون بشریت: معیار آخرین آزمون بشریت (HLE) عملکرد مدل را در ۲۷۰۰سؤال بسیار چالشبرانگیز در دهها موضوع دانشگاهی ارزیابی میکند. این معیار بهعنوان یک معیار بسته در سطح تخصصی با پوشش گسترده و با استفاده از ترکیبی از قالبهای چند گزینهای و پاسخ کوتاه مناسب برای نمرهدهی خودکار طراحی شده است. وظایف نمونه شامل یک سؤال در سطح تحصیلات تکمیلی است که نیاز به اعمال یک مفهوم و ارائه یک پاسخ واحد و قابل تأیید دارد. برخی ممکن است شامل یک تصویر باشند که نیاز به ادغام اطلاعات بصری و متنی توسط مدلها دارد.
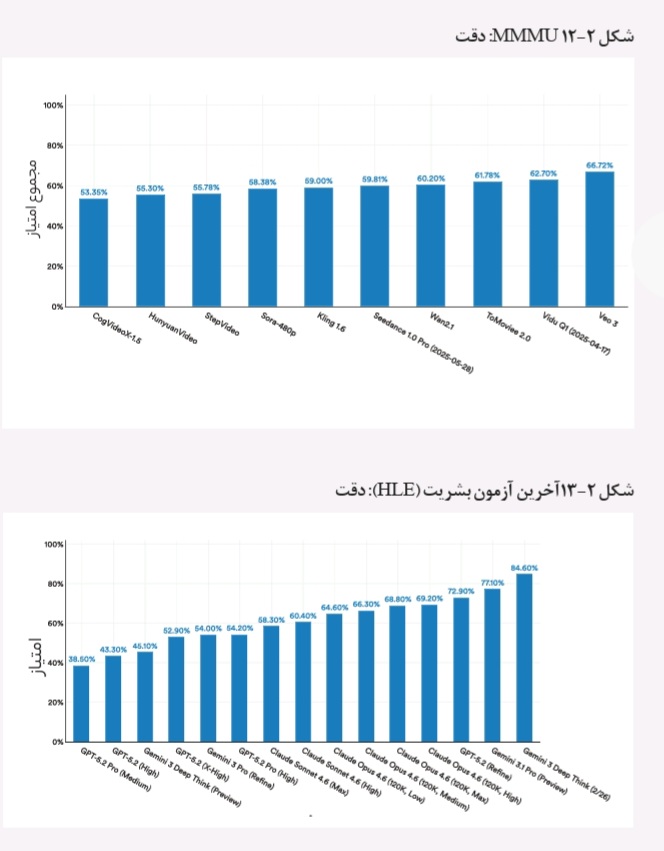
بین سالهای ۲۰۲۴و ۲۰۲۵، دقت مدل در HLE 30درصد افزایش یافته است (شکل ۲-۱۳). در یک سال، دقت از زیر ۱۰درصد به ۳۸.۳درصد رسید.
۲-۴-۲درک زمان در بازاریابی چند سطحی (MLLM)
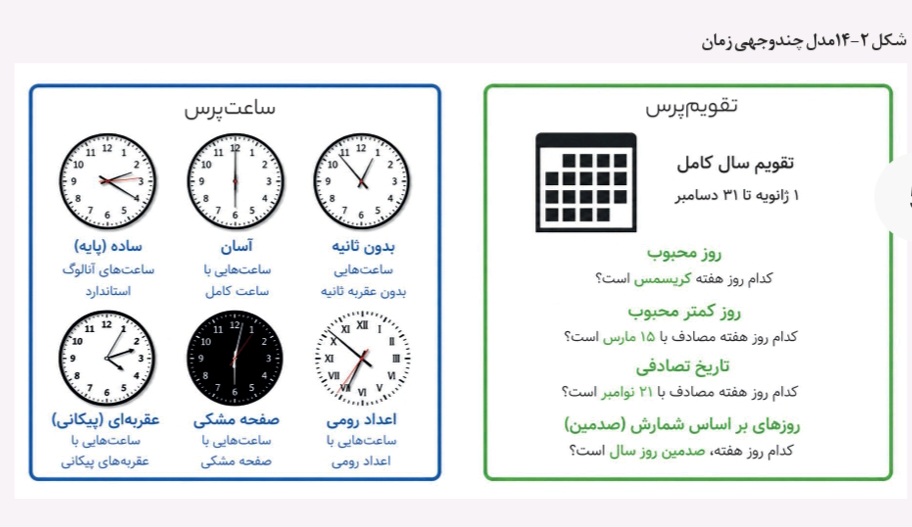
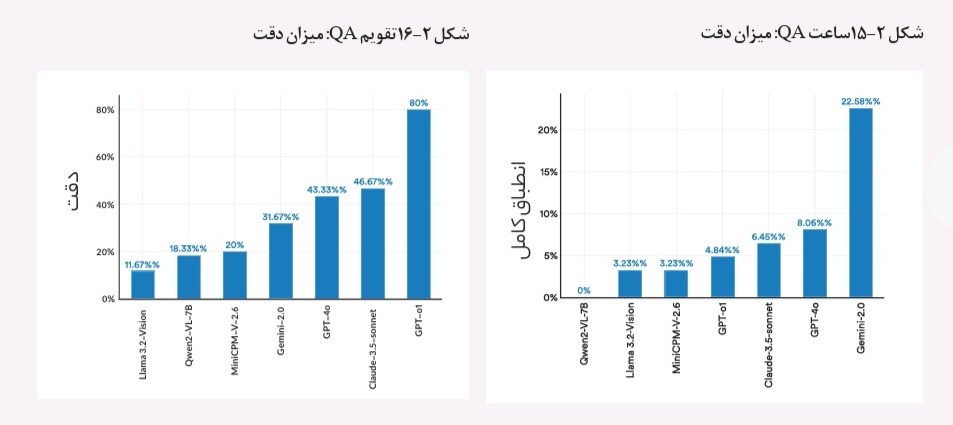
بسیاری از مدلهای چندوجهی هنوز با چیزی که اکثر انسانها آن را عادی میدانند، یعنی گفتن زمان، دست و پنجه نرم میکنند. با وجود پیشرفتهای سریع، مطالعات اخیر نشان میدهد که مدلها در خواندن ساعتهای آنالوگ مشکل دارند. این وظیفه، ادراک بصری را با محاسبات ساده، از شناسایی عقربههای ساعت و موقعیت آنها و سپس تبدیل آنها به مقدار زمان، ترکیب میکند. این خطر وجود دارد که یک خطا در یک مرحله به مرحله بعدی سرایت کند. ساکسنا و همکاران (۲۰۲۵) هفت مدل چندوجهی را روی ۲ مجموعه داده متمرکز آزمایش کردند (شکل ۲-۱۵). ClockQA شامل ۶۲تصویر ساعت آنالوگ در ۶ سبک بصری – ازجمله ساعتهایی با صفحه مشکی یا بدون عقربه ثانیهشمار – و CalendarQA تصاویر تقویم سالانه را با سؤالات استدلال تاریخ جفت میکرد. در خواندن ساعت، حتی مدل با بهترین عملکرد، Gemini-2.0، تنها ۲۲.۶درصد دقت تطابق دقیق را به دست آورد (شکل ۲-۱۵). مدلها در سؤالات تقویم عملکرد بهتری داشتند و GPT-o1به دقت ۸۰درصد رسید، اگرچه وقتی سؤالات به محاسبات تاریخ نیاز داشتند تا تشخیص تعطیلات معروف، خطاهای بیشتری وجود داشت (شکل ۲-۱۶).
ClockBench ارزیابی را به ۱۸۰طرح ساعت و ۷۲۰سؤال افزایش داد. انسانها در ۹۰.۱درصد مواقع ساعتهای قالببندی شده را به درستی خواندند، درحالیکه GPT-5.4، مدل برتر، در مارس ۲۰۲۶به ۵۰.۶درصد رسید (شکل ۲-۱۷). شکاف حدود ۴۰درصدی زیاد است، اما شکاف وسیعتر در ماهیت خطاهاست. وقتی مدلها زمان را اشتباه میگفتند، خطای متوسط آنها از حدود یک تا ۳ ساعت متغیر بود، در مقایسه با ۳ دقیقه برای انسانها.
مطالعهای که در IEEE Internet Computing منتشر شد، بررسی کرد که چرا این شکستها همچنان رخ میدهند. پس از تنظیم دقیق روی ۵۰۰۰ تصویر ساعت مصنوعی، مدلها در سبکهای ساعت آشنا بهبود یافتند، اما نتوانستند به عکسهای دنیای واقعی یا ساعتهایی که ویژگیهای متفاوتی مانند صفحههای تحریفشده یا عقربههای نازکتر داشتند، تعمیم دهند.
وقتی محققان به بررسی خطاها پرداختند، الگویی را شناسایی کردند. اگر یک مدل عقربههای ساعتشمار و دقیقهشمار را اشتباه میگرفت، توانایی آن در تشخیص جهت عقربهها کاهش مییافت. این نشان میدهد که مشکل کمتر از دادههای آموزشی ناشی میشود و بیشتر به نحوه کنار هم قرار دادن چندین نشانه بصری در یک تصویر واحد توسط مدلها مربوط میشود. حتی با اینکه مدلها در وظایف دانشمحور، فاصله خود را با متخصصان انسانی کم میکنند، این نوع استدلال بصری همچنان یک چالش مداوم است.
۲-۴-۳برنامهریزی
علاوه بر استدلال کلی، گزارش شاخص هوش مصنوعی، معیارهای برنامهریزی را دنبال میکند که توانایی مدلها را در توالی اقدامات در چندین مرحله برای دستیابی به یک هدف ارزیابی میکند. مدلها باید آنچه را که قبلاً اتفاق افتاده است، پیگیری کنند، از اقدامات نامعتبر اجتناب کنند و حتی با طولانیتر و پیچیدهتر شدن مشکلات، ثبات را حفظ کنند.
برخلاف سؤالات استدلال تکمرحلهای، ارزیابیهای برنامهریزی میتوانند شکستهایی را که فقط در افقهای طولانیتر ظاهر میشوند، ازجمله خطاهای ترکیبی یا فراموش کردن محدودیتهای قبلی، آشکار کنند. اینکه کدام معیار برای اندازهگیری این قابلیتها استفاده میشود، مهم است، زیرا وظایف مختلف، انواع مختلفی از شکستها را آشکار میکنند.
برنامهریزان کلاسیک مانند LAMA بهطور سیستماتیک در حالتهای ممکن جستوجو میکنند و وقتی راهحلی پیدا میکنند، برنامههای صحیحی تولید میکنند. در عوض، مدلهای زبانی برنامههایی را براساس الگوهای آموخته شده تولید میکنند، به این معنی که میتوانند توالیهای قابلقبولی تولید کنند که میتوانند مراحل نامعتبر داشته باشند یا محدودیتهایی را از دست بدهند.
PlanBench با وادار کردن مدلها به تولید یک برنامه کامل از یک توصیف مسئله ساختاریافته در چندین حوزه برنامهریزی، برنامهریزی سرتاسری را ارزیابی میکند. یک حوزه نوعی مسئله با قوانین و اهداف خاص خود است، مانند چیدن بلوکها بهترتیب خاص، پیمایش مسیرها یا حمل بستهها بین مکانها. این معیار، عملکرد را بهعنوان تعداد وظایف حل شده در هر حوزه گزارش میدهد، با حداکثر ۴۵ وظیفه در هر حوزه، در مقایسه با LAMA بهعنوان یک مبنای برنامهریزی کلاسیک. هیچ مدل واحدی در هر حوزه پیشرو نیست (شکل ۲-۱۸). تحت برنامهریزی استاندارد، LAMA در چندین حوزه پیشرو است، ازجمله Miconic (45/۴۵)، Rovers (۳۴/۴۵) و Transport (۳۳/۴۵).
۲-۵عملکرد در حوزههای خاص
همزمان با بهبود مدلهای هوش مصنوعی در معیارهای استدلال عمومی و دانش، توجه به این موضوع معطوف شده است که آنها در انجام وظایفی که نیاز به تخصص خاصی دارند، چقدر خوب عمل میکنند.
۲-۵-۱نرمافزار
معیارهای کدنویسی آزمایش میکنند که آیا مدلها میتوانند فراتر از پاسخ دادن به سؤالات مربوط به کد عمل کنند و در واقع نرمافزارهای کاربردی بنویسند، اشکالزدایی کنند و ارسال کنند.
SWE-bench مدلها را براساس تواناییشان در حل مسائل نرمافزاری دنیای واقعی که از GitHub جمعآوری شدهاند، ارزیابی میکند. هر وظیفه به مدل یک پایگاه کد و شرح مسئله میدهد و مدل باید یک وصله کاری ایجاد کند. SWE-bench Lite یک زیرمجموعه کوچکتر و در دسترستر است درحالیکه SWE-bench Verified از مسائل اعتبارسنجیشده توسط انسان برای اطمینان از درجهبندی سازگارتر و دقیقتر استفاده میکند.
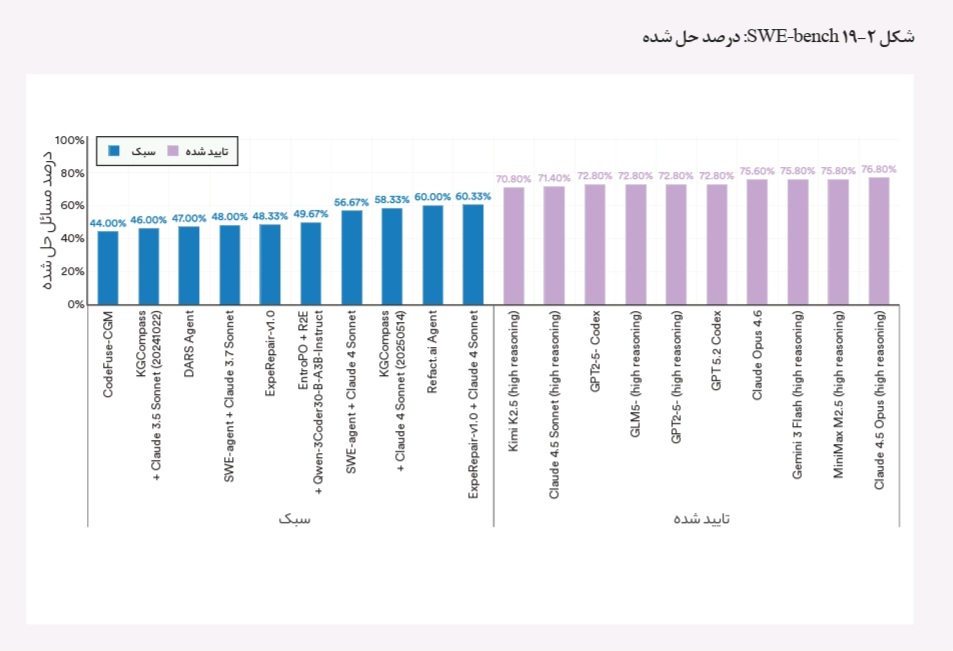
در SWE-bench Verified، مدلهای برتر بهطور فشرده در محدوده پایین تا اواسط دهه ۷۰ خوشهبندی شدهاند (شکل ۲-۱۹). از فوریه ۲۰۲۶، Claude 4.5Opus (با استدلال بالا) تقریباً با ۷۶.۸درصد پیشتاز بود و چندین مدل دیگر ازجمله KimiK2.5، GPT-5.2و Gemini 3(با استدلال بالا) بین ۷۰درصد تا ۷۶درصد گروهبندی شدند.
۲-۵-۲ریاضیات
فراتر از کدنویسی و وظایف زبانی، ریاضیات به یک زمینه آزمایش کلیدی برای استدلال مدل تبدیل شده است. معیارهای این بخش از حل مسئله در سطح مسابقه تا نوشتن اثبات رسمی متغیر است.
FrontierMath: معیاری است که توسط Epoch AI معرفی شده است و صدها مسئله ریاضی اصلی و فوقالعاده چالشبرانگیز را ارائه میدهد. این مسائل برای آزمایش استدلال ریاضی واقعی به جای تشخیص الگو طراحی شدهاند و حتی ریاضیدانان باتجربه نیز ممکن است برای حل آنها به ساعتها یا روزها زمان نیاز داشته باشند.
از سال ۲۰۲۴، دقت در FrontierMath Tier 4از نزدیک به صفر درصد به ۳۱.۳درصد افزایش یافته است و GPT-5.2Pro (وب اپلیکیشن) تا پایان سال ۲۰۲۵پیشتاز است (شکل ۲-۲۰). این معیار بهگونهای طراحی شده است که دشوار باقی بماند، بنابراین حتی با این صعود شدید در مدت زمان کوتاه، بهترین مدلها هنوز هم در تقریباً ۲ از ۳ مسئله در سختترین سطح شکست میخورند.
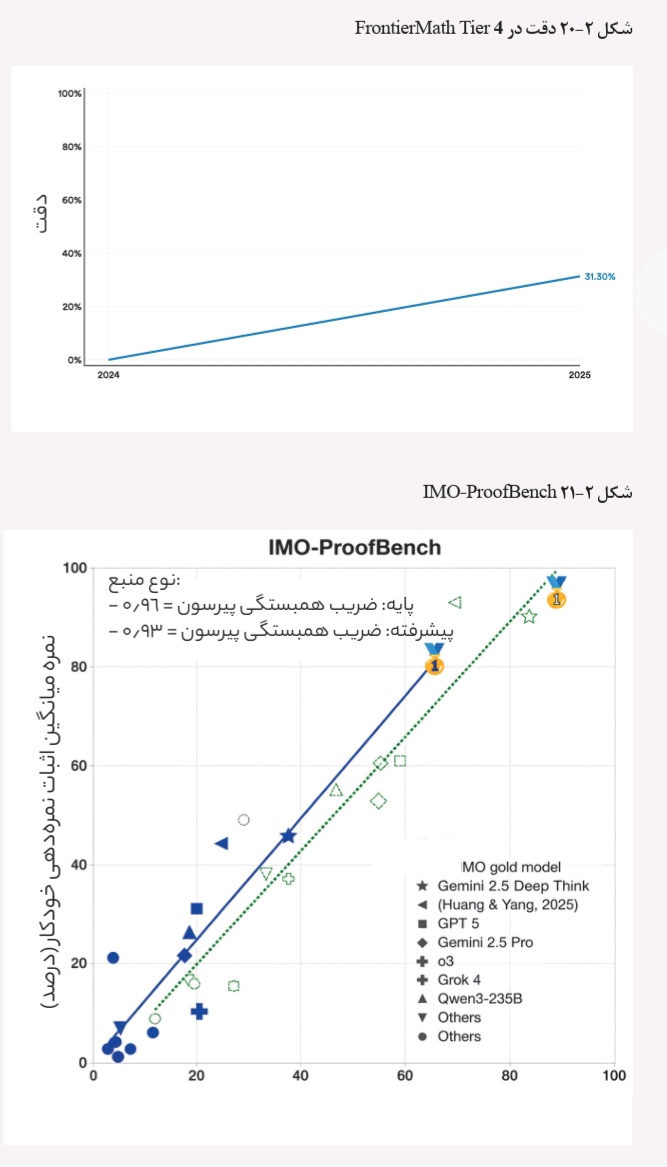
اثبات قضیه: در ریاضیات، رسیدن به پاسخ درست تنها بخشی از چالش است. نتیجهای صحیح که با استدلال ناقص پشتیبانی شود، اعتبار کمی در یک مسابقه یا در یک مجله کسب میکند. اثبات قضیه، فرایند ساخت یک استدلال دقیق و گام به گام برای اینکه چرا یک نتیجه باید درست باشد، همچنان یکی از سختترین وظایف سیستمهای هوش مصنوعی است. تا همین اواخر، حتی مدلهای مرزی نیز برای تولید اثباتهایی که بتوانند از بررسی تخصصی عبور کنند، تلاش میکردند. AlphaProof و AlphaGeometry 24 از ۶ مسئله را در المپیاد بینالمللی ریاضی (IMO) 2024حل کردند و با ۲۸امتیاز مدال نقره را از آن خود کردند. این نتیجه نیاز به متخصصانی داشت تا مسائل را به زبانهای رسمی مانند Lean ترجمه کنند و روزها محاسبه طول میکشید. در سال ۲۰۲۵، Gemini Deep Think 5 مسئله از ۶ مسئله را حل کرد و ۳۵ امتیاز کسب و مدال طلا را از آن خود کرد، درحالیکه در محدوده زمانی ۴.۵ ساعته مسابقه، به زبان طبیعی بهصورت پیوسته کار میکرد. جهش از نقره به طلا در یک سال، یکی از سریعترین دستاوردهای قابلیت در ریاضیات رقابتی را نشان میدهد.
IMO-ProofBench ارزیابی میکند که آیا مدلها میتوانند اثباتهای گام به گام دقیقی برای ۶۰ مسئله از قبل از IMO تا دشواری کامل IMO تولید کنند یا خیر. در IMO-ProofBench، نمرات اختصاص دادهشده توسط یک سیستم درجهبندی خودکار، نمرات دادهشده توسط متخصصان انسانی را به دقت دنبال میکند، با همبستگی پیرسون ۰.۹۶ در مسائل پایه و ۰.۹۳ در مسائل پیشرفته. این سطح از توافق نشان میدهد که درجهبندی خودکار میتواند یک جایگزین منطقی باشد، اگرچه نویسندگان معیار، تأیید انسانی را برای نتایج با ریسک بالا توصیه میکنند. با اعتبارسنجی این رویکرد درجهبندی، نتایج معیار، میزان شکاف بین مدلها را نشان میدهد (شکل ۲-۲۱). Aletheia با ۹۱.۹درصد پیشتاز است و پس از آن Gemini 3Deep Think با ۷۶.۷درصد و Gemini Deep Think (IMO Gold) با ۶۵.۷درصد قرار دارند.
۲-۵-۳امور مالی
این بخش معیارهایی را پوشش میدهد که برای ارزیابی سیستمهای هوش مصنوعی در وظایف خاص مالی طراحی شدهاند. برخلاف معیارهای استدلال عمومی، این آزمونها به مدلهایی نیاز دارند که زبان خاص دامنه را مدیریت کنند، اطلاعات ساختاریافته را از اسناد مالی استخراج کنند و قضاوت حرفهای را در زمینههایی ازجمله قانون مالیات، فرایند وام مسکن و تحلیل مالی اعمال کنند.
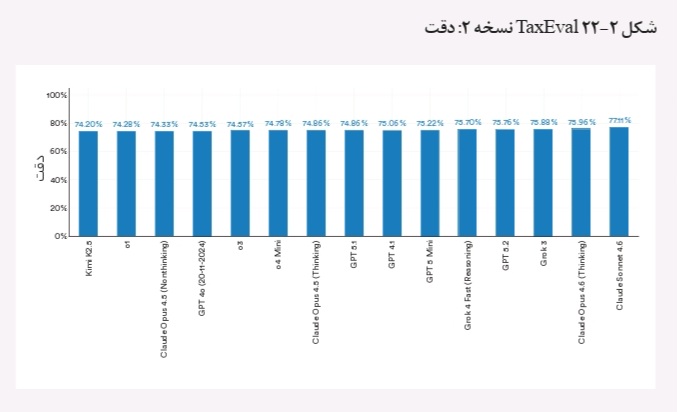
در یکی از این نوع آزمونها مثلا TaxEval نسخه ۲ معیاری است که برای آزمایش چگونگی عملکرد مدلها در رسیدگی به سؤالات چالشبرانگیز مربوط به مالیات طراحی شده است. این شامل بیش از ۱۵۰۰ سؤال تأییدشده توسط متخصصان است که با استفاده از نظرات متخصصان مالیات و امور مالی تهیه شده است و شامل استدلال عددی، تحلیل معنایی، حل مسئله و اعمال قوانین انطباق است. مدلها براساس ۲ بعد امتیازدهی میشوند: اینکه آیا پاسخ واقعاً صحیح است و اینکه آیا استدلال گام به گام واضح و حرفهای است یا خیر.
عملکرد در TaxEval نسخه ۲ تنها تفاوت کمی را در بین مدلها نشان میدهد (شکل ۲-۲۲). هر ۱۵ مدل برتر در یک بازه ۳ درصدی قرار میگیرند، از ۷۷.۱درصد (Claude Sonnet 4.6) تا ۷۴درصد (Claude 3.7Sonnet Thinking)
2-5-4حقوق مصنوعی
هوش مصنوعی نیز در حوزه حقوقی مورد ارزیابی قرار میگیرد، جایی که وظایف تفسیر تصمیمات دادگاه تا قوانین براساس الگوهای جدید را شامل میشود. مواردی که زیر پوشش قرار گرفتهاند، نشان میدهند که مدلها چگونه وظایف استدلال حقوقیای را دارند که نیاز به پایهگذاری در اسناد عمومی خاص دارند، نه دانش.
در یکی از این نوع آزمونها مثلا CaseLaw نسخه ۲ کیفیتی برای ارزیابی LLMها در دعاوی حقوقی و وظایف تحقیقات حقوقی در دنیای واقعی است. این شامل ۳۰۰ آزمون اعتبارسنجی و ۱۰۴ آزمون آزمایشی – شامل استدلال تکموردی و چند موردی – در ۷ بعد از استدلال حقوقی، ازجمله بازیابی سوابق کلیدی، پاسخ به سؤالات چند سندی، محاسبات، جداول و استدلال زمانی است. GPT-5.1با دقت ۷۳.۴درصد از CaseLaw v2پیشی گرفته و GPT 4.1با دقت ۶۹.۹درصد در رتبه بعدی قرار دارد (شکل ۲-۲۳).
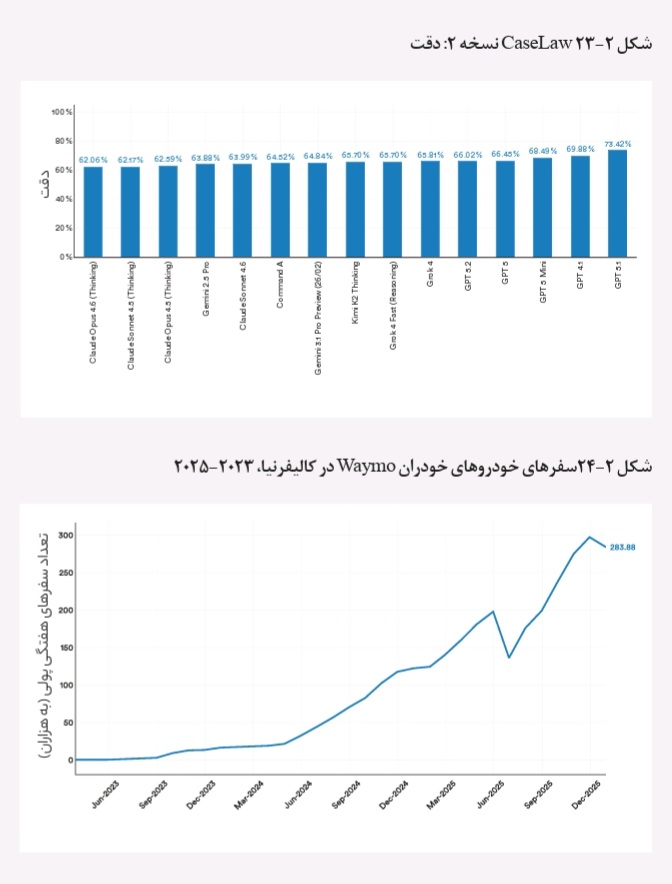
بقیه ۱۵مدل برتر بین ۶۲درصد تا ۶۶درصد قرار دارند، که نشان میدهد جای پیشرفت معناداری وجود دارد.
۲-۶رباتیک و حرکت خودکار
۲-۶-۱رباتیک انساننما
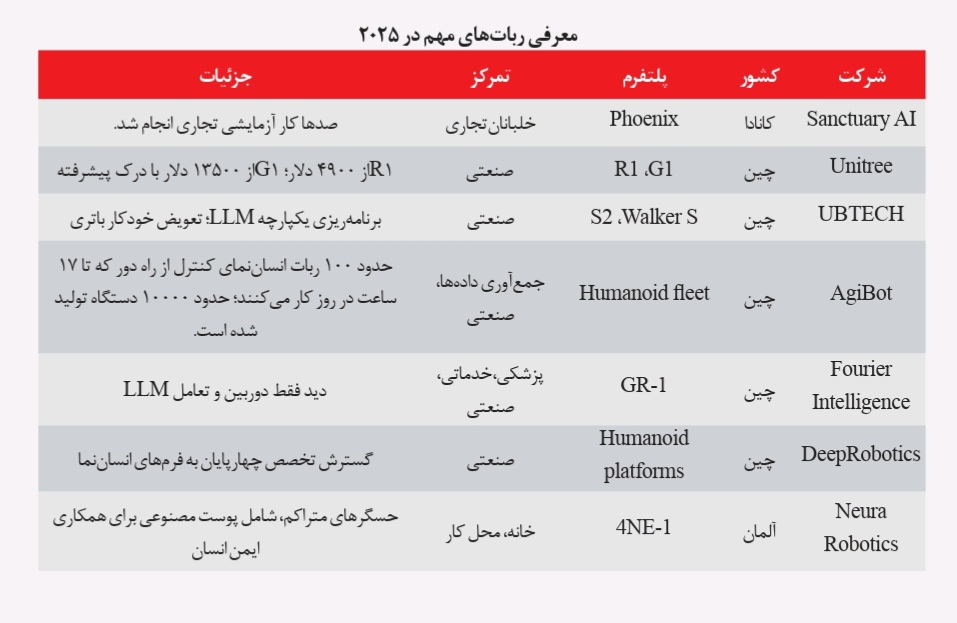
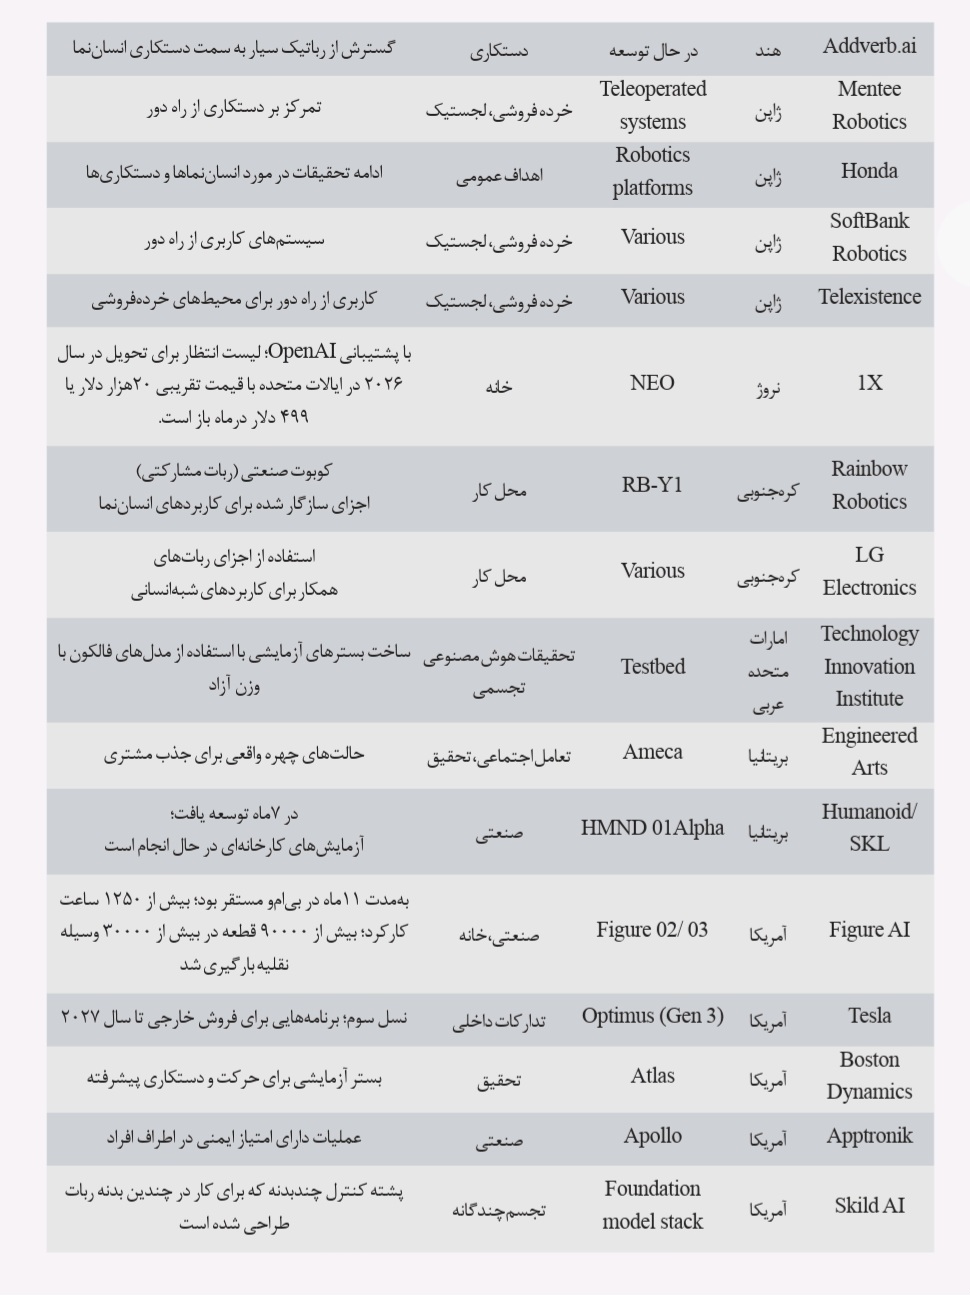
رباتهای انساننما در سال ۲۰۲۴ با عرضه سختافزارهای جدید از سوی شرکتهایی مانند Figure AI، تسلا و بوستون داینامیکس، توجه بسیاری را بهخود جلب کردند. در سال ۲۰۲۵، این حوزه با افزایش قابلتوجه در تعداد و تنوع پلتفرمهای انساننمای موجود به رشد خود ادامه داد.
قویترین سیگنالها از پروژههای آزمایشی صنعتی در مراحل اولیه و جاهطلبیهای در مقیاس تولید به جای استقرار گسترده بهدست آمد. بهعنوان مثال، ربات AI’s Figure 02از Figure AI، ۱۱ماه را در خط تولید کارخانه BMW در کارولینای جنوبی گذراند و بیش از ۱۲۵۰ ساعت کار کرد و بیش از ۹۰۰۰۰ قطعه را در بیش از ۳۰۰۰۰ وسیله نقلیه بارگیری کرد. در چین، فروشندگانی مانند Unitree و AgiBot قیمتها را کاهش و حجم تولید را افزایش دادند و رباتهای انساننما را بهعنوان محصولات سختافزاری شبهمصرفی به جای سیستمهای تحقیقاتی سفارشی معرفی کردند. برخی از شرکتها محیطهای خانگی را برای رباتهای انساننمای خود هدف قرار میدهند، بهطوری که شرکت نروژی ۱X لیست انتظاری برای تحویل ربات خانگی ۲۰هزار دلاری خود باز کرده است. تصویر کلی، رشد سریع در دسترسی به سختافزار و فعالیتهای سرمایهگذاری را به جای استقرار گسترده نشان میدهد. هنوز مشخص نیست که آیا تقاضا برای رباتهای انساننما با عرضه فعلی در حال ساخت مطابقت خواهد داشت یا خیر، مشتریان در مقیاس بزرگ چه کسانی خواهند بود و این پلتفرمها با چه سرعتی از پروژههای آزمایشی کارخانهای ساختاریافته به محیطهای بدون ساختار منتقل میشوند.
۲-۶-۲خودروهای خودران
توسعه خودروهای خودران در چندین بازار از مرحله تحقیق عبور کرده است و خدمات تجاری اکنون در مقیاس وسیع فعالیت میکنند. این بخش روندهای استقرار، نوآوریهای فنی در معیارها و مجموعه دادهها و ایمنی را از طریق دادههای گزارش تصادف ردیابی میکند. دادههای موجود برای این بخش در ایالات متحده و تا حد کمتری در چین متمرکز است. اپراتورهای خودروهای خودران اروپایی مانند Mobileye، Vay و Wayve فعال هستند، اما دادههای سفر یا استقرار قابل مقایسه در دسترس عموم نیست. دادههای چین نیز محدود است، بهطوری که Apollo Go بایدو یکی از معدود سرویسهایی است که آمار دقیقی از مسافران را منتشر میکند.
استقرار: استقرار خودروهای خودران در سال ۲۰۲۵با رشد در ایالات متحده و چین شتاب گرفت. تا اواخر سال ۲۰۲۵، Waymo تقریباً ۲۵۰۰تاکسی رباتیک کاملاً خودران را در شهرهای بزرگ ایالات متحده، ازجمله فینیکس، سانفرانسیسکو، لسآنجلس، آستین و آتلانتا، اداره میکرد و این سرویس حدود ۴۵۰۰۰۰سفر هفتگی را ثبت میکرد. تنها در کالیفرنیا، سفرهای هفتگی با هزینه از نزدیک به صفر در اواسط سال ۲۰۲۳به تقریباً ۲۸۳۸۸۰تا اواخر سال ۲۰۲۵افزایش یافت و پس از فوریه ۲۰۲۵رشد چشمگیری داشت. Zoox، یک اپراتور کوچکتر، در اواخر سال ۲۰۲۵در دادههای سفر آزمایشی کالیفرنیا ظاهر شد. در چین، سرویس درخواست سواری خودران Apollo Go بایدو در سال ۲۰۲۵تقریباً ۱۱میلیون سفر کاملاً بدون راننده ارائه داد که افزایشی ۱۷۵درصدی نسبت به سال گذشته را نشان میدهد. این سرویس از ۱.۵ میلیون سفر در سال ۲۰۲۲به ۱۱میلیون سفر در سال ۲۰۲۵افزایش یافته است که نشاندهنده گسترش سریع استفاده از آن است.
ایمنی: دستور عمومی دائمی (دستور عمومی) در مورد گزارش تصادفات، یک دستورالعمل از سوی اداره ملی ایمنی ترافیک بزرگراهها (NHTSA) است که تولیدکنندگان و اپراتورها را ملزم به گزارش تصادفات خاصی میکند که شامل سیستمهای رانندگی خودکار (ADS) یا سیستمهای پیشرفته کمک راننده سطح ۲SAE (ADAS) میشوند.
این دستور که نخستین بار در سال ۲۰۲۱صادر و در سالهای ۲۰۲۱، ۲۰۲۳و ۲۰۲۵اصلاح شد، دادههای تصادف ثابتی را در اختیار NHTSA قرار میدهد تا حوادث را بررسی و الزامات ایمنی را اجرا کند.
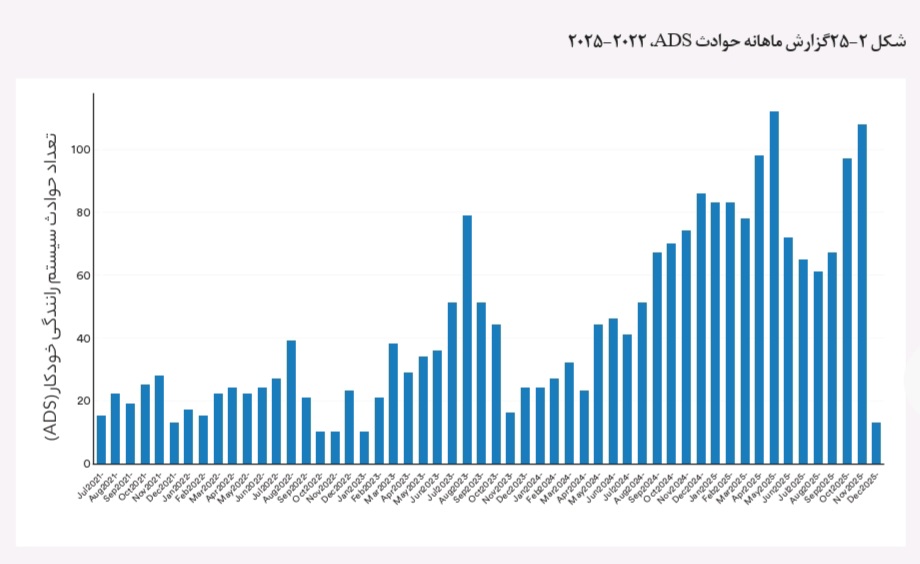
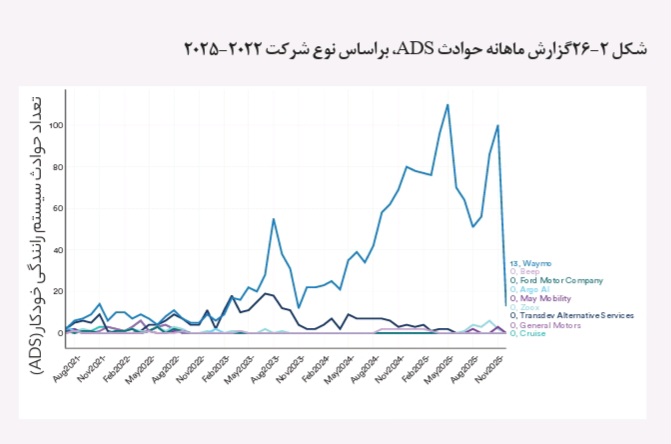
از زمانی که NHTSA شروع به جمعآوری دادهها در اواسط سال ۲۰۲۱کرد، حوادث ADS گزارش شده ماهانه عموماً روند صعودی داشتهاند و از تقریباً ۱۰تا ۲۵مورد در ماه در سالهای اولیه به ۸۰مورد در ماه در اواخر سال ۲۰۲۴و ۲۰۲۵افزایش یافتهاند (شکل ۲-۲۵). وقتی براساس شرکت تقسیمبندی میشود، Waymo بیشترین سهم از حوادث گزارش شده را بهخود اختصاص میدهد که با میزان استقرار بسیار بزرگتر آن سازگار است. سایر اپراتورها، ازجمله فورد، میموبیلیتی و ترنسدف آلترناتیو سرویسز، تعداد حوادث کمتر و پایدارتری را گزارش میکنند. (شکل ۲-۲۶)
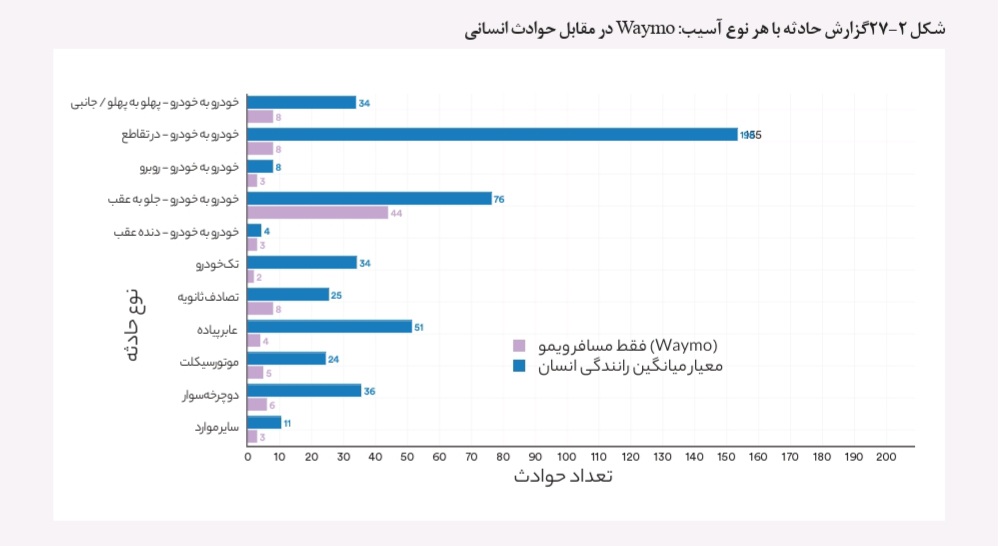
بدون مقایسه با رانندگی انسان، تفسیر تعداد خام تصادفات دشوار است. وایمو دادههایی را منتشر کرده است که نرخ تصادفات فقط توسط راننده را با معیار رانندگی انسان که مسافتها و مناطق یکسانی را پوشش میدهد، مقایسه میکند. نرخهای گزارششده توسط وایمو هم برای حوادث گزارششده با هرگونه آسیب (شکل ۲-۲۷) و هم برای حوادث گزارششده با باز شدن کیسه هوا کمتر است. بزرگترین شکاف در حوادث تقاطع خودرو با خودرو ظاهر میشود، جایی که معیار انسانی ۱۹۸مورد را در مقایسه با ۸مورد توسط وایمو ثبت کرده است.


دیدگاهتان را بنویسید