
به گزارش دانشمند، طبق گزارش «مؤسسه هوش مصنوعی انسانمحور»، منابعی که توسعه هوش مصنوعی را تقویت میکنند، در سال ۲۰۲۵ همچنان به رشد خود ادامه دادند، اما مدلهای قابلتوجه (Notable AI Models) کمتری نسبت به سال قبل منتشر شدند و سیستمهای پیشرو بهطور فزایندهای در بین تعداد کمی از سازمانها متمرکز شدهاند.
اکنون صنعت بیش از ۹۰درصد از مدلهای قابلتوجه هوش مصنوعی را تشکیل میدهد و توانمندترین سیستمها نیز کمترین شفافیت را دارند و کد آموزشی، اندازه مجموعه دادهها و تعداد پارامترها بهطور فزایندهای پنهان نگه داشته میشوند. قدرت محاسباتی پشت این مدلها از سال ۲۰۲۲ تقریباً ۳.۳ برابر در سال رشد کرده است اما تقریباً همه آن از طریق یک کارخانه ریختهگری تراشه در تایوان جریان دارد و زنجیره تأمین سختافزار جهانی را شکننده میکند. توسعه منبع باز و انتشارات هوش مصنوعی همچنان در حال رشد هستند و چشمانداز تحقیقات از نظر جغرافیایی در حال گسترش است. چین اکنون در حجم انتشارات، سهم استناد و اعطای حق ثبت اختراع پیشرو است، درحالیکه کشورهای کوچکتر مانند سوئیس و سنگاپور در سرانه محققان هوش مصنوعی پیشرو هستند.
با این حال برخی از ابعاد این حوزه به هیچ وجه تغییر نکرده است. شکاف جنسیتی در استعدادهای هوش مصنوعی همچنان عمیقاً ریشه دوانده است و از سال ۲۰۱۰ هیچ پیشرفت معناداری در هیچ کشوری مشاهده نشده است.
نکات برجسته:
۱. صنعت در سال ۲۰۲۵ بیش از ۹۰درصد از مدلهای هوش مصنوعی قابل توجه را تولید کرد، اما توانمندترین مدلها اکنون کمترین شفافیت را دارند. کد آموزشی، تعداد پارامترها، اندازه مجموعه دادهها و مدت زمان آموزش برای چندین سیستم با بیشترین منابع، ازجمله سیستمهای OpenAI، Anthropic و Google، دیگر افشا نمیشوند.
۲. چین در تحقیقات پیشرو است، درحالیکه ایالات متحده در توسعه مدلهای قابل توجه پیشرو است. چین در حجم انتشار، استنادها و اعطای حق ثبت اختراع پیشرو است، درحالیکه ایالات متحده حق ثبت اختراعات با تأثیر بالاتر را حفظ کرده و در سال ۲۰۲۵، ۵۰ مدل قابل توجه تولید کرده است که این رقم برای چین ۳۰ است. کرهجنوبی در سرانه حق ثبت اختراعات هوش مصنوعی پیشرو است و سهم چین از ۱۰۰ مقاله برتر هوش مصنوعی با بیشترین استناد از ۳۳ در سال ۲۰۲۱ به ۴۱ در سال ۲۰۲۴ افزایش یافته است.
۳. پارامترهای گزارش شده هنوز در سطح تریلیون است، زیرا افشا کاهش یافته است. تعداد پارامترها بهمدت ۳ سال نزدیک به یک تریلیون باقی مانده است، اگرچه گزارش از آزمایشگاههای پیشرو متوقف شده است. محاسبات آموزشی، که میتوان بهطور مستقل تخمین زد، همچنان در حال افزایش است.
۴. دادههای مصنوعی هنوز جایگزین دادههای واقعی در پیشآموزش نمیشوند، اما کیفیت دادهها و تکنیکهای پس از آموزش نویدبخش هستند. OLMo 3.1Think 32B، با پارامترهای تقریباً ۹۰ برابر کمتر از Grok 4، تنها از طریق هرس، حذف دادههای تکراری و اصلاح، به نتایج قابل مقایسهای در چندین معیار دست مییابد.
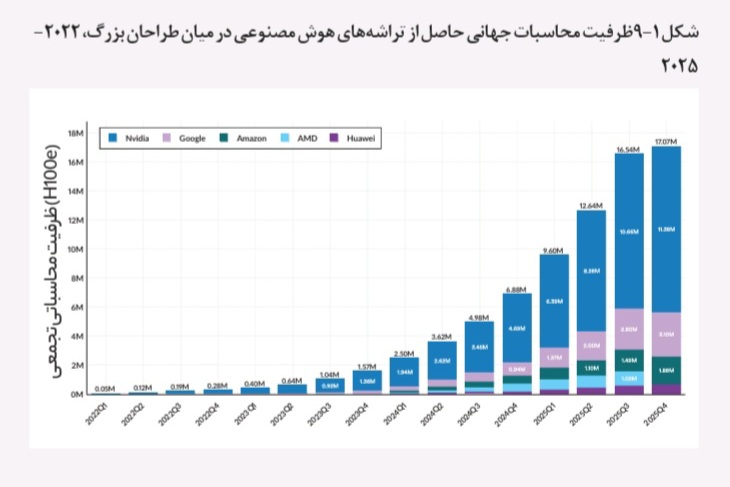
۵. ظرفیت محاسبات جهانی هوش مصنوعی از سال ۲۰۲۲، سالانه ۳.۳ برابر رشد کرده و به ۱۷.۱ میلیون تراشه H100رسیده است. انویدیا بیش از ۶۰درصد از کل محاسبات را بهخود اختصاص داده است، گوگل و آمازون بخش عمدهای از بقیه را تأمین میکنند و هواوی سهم کوچک اما رو به رشدی را در اختیار دارد. این افزایش بهدلیل گسترش مراکز داده hyperscaler و تقاضای پایدار برای آموزش و استنتاج مدل پیشرو است.
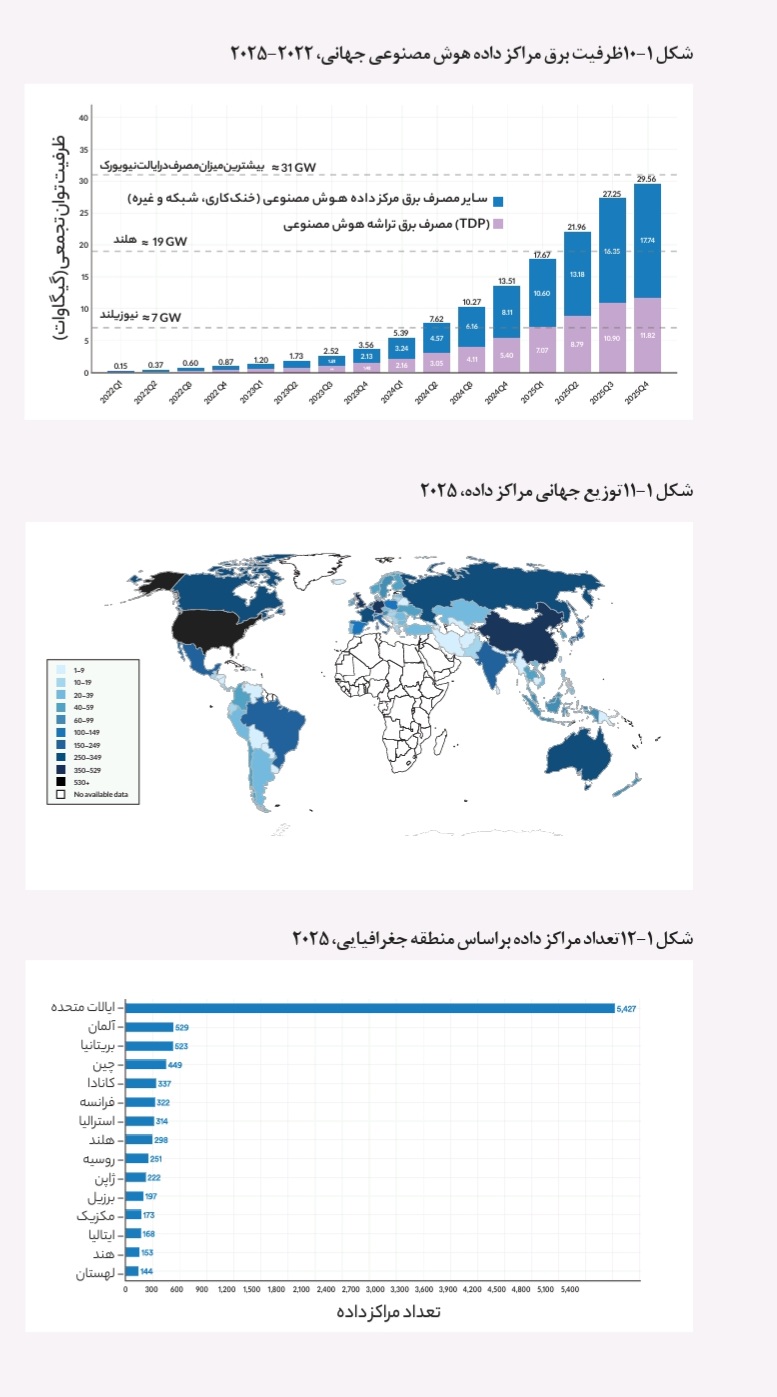
۶. ایالات متحده در مراکز داده هوش مصنوعی پیشرو است و یک کارخانه ریختهگری تایوانی اکثر تراشههای داخل آنها را تولید میکند. ایالات متحده میزبان ۵۴۲۷ مرکز داده است که بیش از ۱۰ برابر هر کشور دیگری است و انرژی بیشتری نسبت به هر منطقه دیگری مصرف میکند. یک شرکت واحد، TSMC، تقریباً هر تراشه هوش مصنوعی پیشرو را تولید میکند و زنجیره تأمین سختافزار هوش مصنوعی جهانی را به یک کارخانه ریختهگری در تایوان وابسته میکند، اگرچه TSMC در ایالات متحده در سال ۲۰۲۵ شروع بهکار کرد.
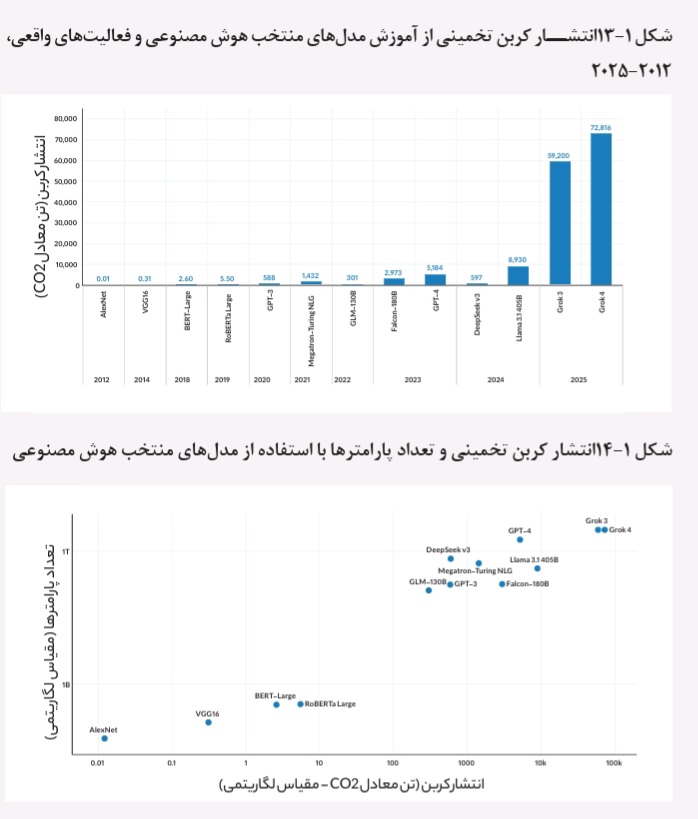
۷. اثرات زیستمحیطی هوش مصنوعی در زمینههای برق، آب و انتشار گازهای گلخانهای افزایش مییابد. در سال ۲۰۲۵، انتشار گازهای گلخانهای تخمینی Grok 4به ۷۲۸۱۶ تن معادل CO₂ رسید. ظرفیت برق مرکز داده هوش مصنوعی به ۲۹.۶ گیگاوات افزایش یافت که قابل مقایسه با ایالت نیویورک در اوج تقاضاست و مصرف سالانه آب به تنهایی ممکن است از نیاز آب آشامیدنی ۱۲ میلیون نفر فراتر رود.
۸. توسعه هوش مصنوعی متنباز همچنان در حال گسترش است و ۵.۶ میلیون پروژه در گیتهاب وجود دارد و آپلودهای Hugging Face از سال ۲۰۲۳ سه برابر شده است. پروژههای مستقر در ایالات متحده هنوز بیشترین تعامل را جذب میکنند، با ۳۰ میلیون ستاره تجمعی گیتهاب در پروژههایی که از آستانه ۱۰ ستاره عبور کردهاند.
۹. تعداد محققان و توسعهدهندگان هوش مصنوعی که به ایالات متحده مهاجرت میکنند از سال ۲۰۱۷، ۸۹ درصد کاهش یافته است. این کاهش در حال شتاب گرفتن است و تنها در سال گذشته ۸۰ درصد کاهش یافته است. ایالات متحده هنوز هم بیش از هر کشور دیگری میزبان استعدادهای هوش مصنوعی است، اما با کمترین نرخ در بیش از یک دهه، استعدادهای جدید را جذب میکند.
۱۰. نقشه استعدادهای هوش مصنوعی در حال تغییر است، اما شکافهای جنسیتی همچنان عمیقاً پابرجاست. سوئیس و سنگاپور در سرانه محققان و توسعهدهندگان هوش مصنوعی در جهان پیشرو هستند و برخی کشورها، ازجمله عربستان سعودی (۳۲.۳ درصد)، کانادا (۲۹.۶ درصد) و استرالیا (۳۰.۱ درصد)، حضور زنان نسبتاً بالاتری را نشان میدهند، اگرچه هیچ کشوری به برابری جنسیتی نزدیک نمیشود.
۱-مدلهای هوش مصنوعی قابل توجه (Notable AI Models)
با استفاده از مجموعه دادههای گردآوریشده توسط Epoch AI از مدلهای قابل توجه، این بخش بررسی میکند که مدلهای هوش مصنوعی پیشرو از کجا میآیند، چگونه مستقر میشوند و برای ساخت آنها چه چیزی لازم است. Epoch AI مدلها را براساس معیارهایی مانند پیشرفتهای پیشرفته، اهمیت تاریخی یا نرخ بالای استناد، بهعنوان مدلهای قابل توجه تعیین میکند. این یک گردآوری دستی است، بنابراین مجموعه دادهها سرشماری از تمام مدلهای هوش مصنوعی یا نقشه کاملی از تمام فعالیتهای توسعه مدل نیست. روندها باید بهعنوان الگوهایی در داخل دامنه درنظر گرفته شوند.
۱-۱- براساس وابستگی ملی
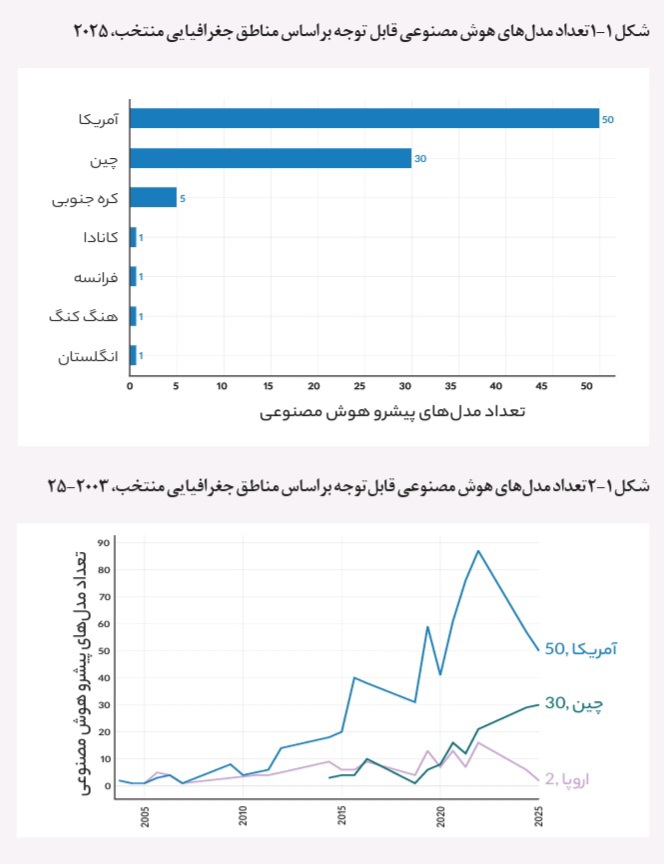
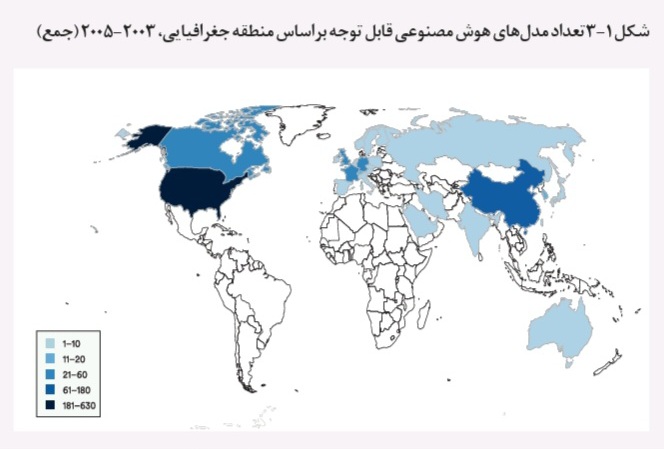
تولید مدلهای قابلتوجه همچنان در تعداد کمی از کشورها متمرکز است (شکلهای ۱-۱تا ۱-۲). از نظر تاریخی، ایالات متحده بیشترین تعداد کل خروجی را تولید کرده است و پس از آن چین قرار دارد. این الگو در سال ۲۰۲۵ نیز ادامه یافت، زیرا ایالات متحده با انتشار ۵۰ مدل هوش مصنوعی قابل توجه، چین با ۳۰ مدل و کرهجنوبی با ۵ مدل پیشتاز بودند. تعداد مدلهای جدید منتشر شده در تمام مناطق جغرافیایی اصلی سال به سال کاهش یافت.
۱-۲- براساس بخش و سازمان
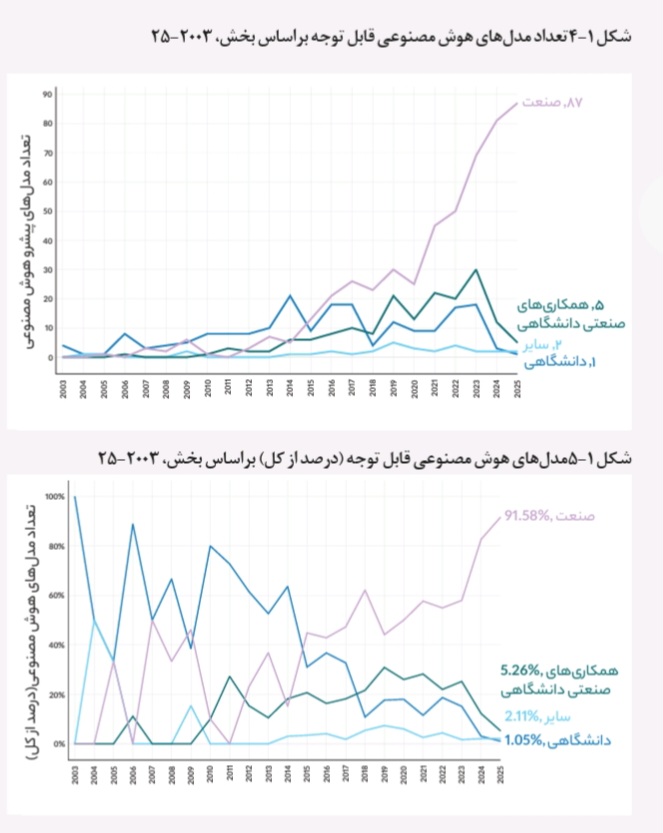
توسعه مدلهای قابل توجه هوش مصنوعی همچنان عمدتاً در صنعت متمرکز است (شکلهای ۱-۴و ۱-۵). در طول دهه گذشته، سهم تولیدشده توسط صنعت بهطور پیوسته افزایش یافته و اکنون با اختلاف زیادی (۹۱.۶درصد) بزرگترین سهم را نشان میدهد. در سال ۲۰۲۵، Epoch AI یک مدل قابل توجه هوش مصنوعی را که از دانشگاه سرچشمه گرفته بود، در مقایسه با ۸۷ مدل از صنعت، شناسایی کرد.
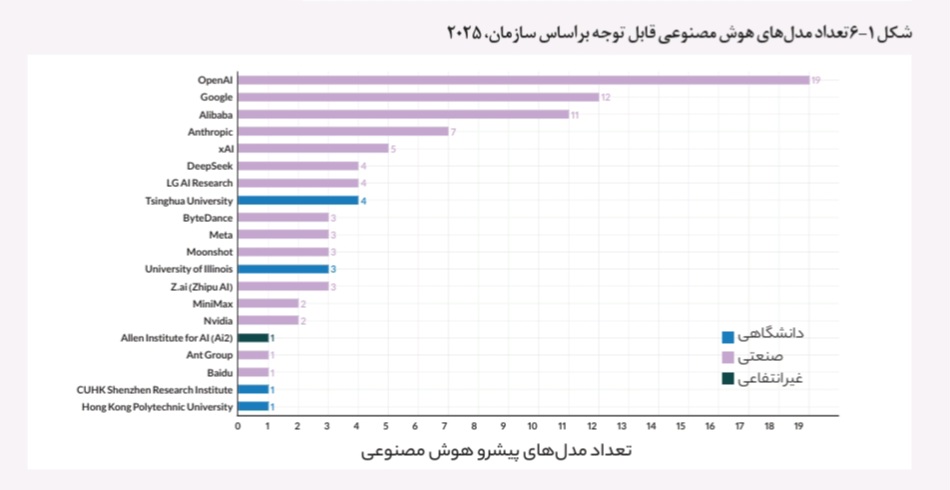
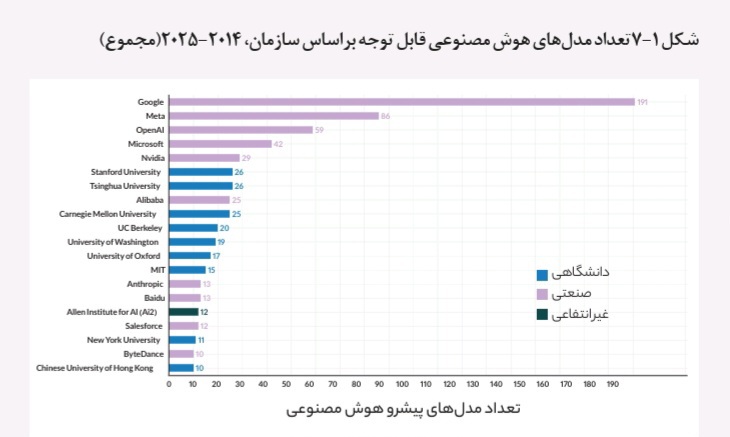
در صنعت، مجموعه کوچکی از سازمانها سهم بزرگی از انتشارها را بهخود اختصاص میدهند (شکلهای ۱-۶و ۱-۷). در سال ۲۰۲۵، مشارکتکنندگان برتر OpenAI (19)، گوگل (۱۲) و علیبابا (۱۱) بودند. از سال ۲۰۱۴، گوگل بیشترین تعداد مدلهای قابلتوجه را تولید کرده است و پس از آن Meta و OpenAI قرار دارند. در حوزه آکادمیک، دانشگاههای تسینگهوا (۲۶)، استنفورد (۲۶) و کارنگی ملون (۲۵) در طول دهه گذشته پرکارترین دانشگاهها بودهاند.
نکته:
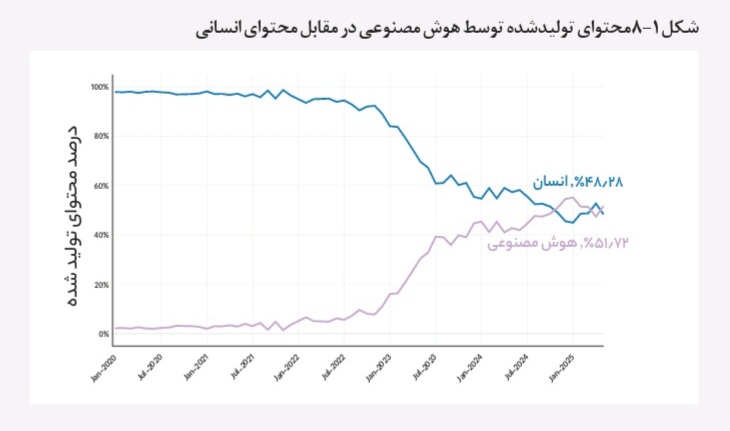
از زمان راهاندازی ChatGPT در نوامبر ۲۰۲۲، پیشبینیهایی وجود داشته است مبنی بر اینکه اینترنت بهزودی توسط محتوای تولید شده به وسیله هوش مصنوعی اشغال خواهد شد. تحقیقات اخیر نشان میدهد که از ژانویه ۲۰۲۵، بیش از ۵۰درصد از محتوای آنلاین تازه منتشرشده توسط هوش مصنوعی تولید شده است (شکل ۱-۸). دیگران پیشبینی کردهاند که این سهم در سال ۲۰۲۶ میتواند حتی بیشتر باشد.
۲-محاسبات و زیرساخت
توسعه مدلهای هوش مصنوعی نیازمند سرمایهگذاری زیرساختی قابلتوجهی است. با گسترش مقیاس و پیچیدگی فرایندهای آموزشی، سختافزار زیربنایی نیز از نظر سرعت و کارایی بهبود یافته است. در عوض، این دستاوردها، نوع مدلهایی را که محققان و آزمایشگاهها میتوانند بهطور واقعبینانه بسازند، شکل میدهند. رشد محاسبات آموزشی بدون پیشرفتهای مربوطه در قابلیتهای سختافزاری امکانپذیر نبود. این بخش از دادههای Epoch AI برای ردیابی عملکرد سختافزار، پذیرش و ظرفیت محاسباتی کل در طول زمان استفاده میکند.
۲-۱ظرفیت محاسبات جهانی
عرضه ظرفیت محاسبات هوش مصنوعی از طراحان اصلی تراشه همچنان در حال افزایش است (شکل ۱-۹). ظرفیت کل از سال ۲۰۲۲سالانه ۳.۳برابر افزایش یافته و تقریباً به معادل ۱۷.۱میلیون تراشه H100رسیده است. تراشههای هوش مصنوعی انویدیا در حال حاضر بیش از ۶۰درصد از کل محاسبات را تشکیل میدهند، گوگل و آمازون بخش عمدهای از بقیه را تأمین میکنند و هواوی سهم کوچک اما رو به رشدی را در اختیار دارد. رشد ظرفیت محاسبات با الگوهای سرمایهگذاری شرح داده شده در بخش ۴مطابقت نزدیکی دارد، جایی که شرکتهای پیشرو در هوش مصنوعی هزینههای سرمایهای خود را افزایش دادهاند و زیرساختها به سریعترین حوزه تمرکز در حال رشد بودجه هوش مصنوعی خصوصی تبدیل شدهاند.
۲-۲- ظرفیت برق مرکز داده
گسترش ظرفیت محاسبات، هزینه انرژی مستقیمی را به همراه دارد. کل ظرفیت برق مرکز داده هوش مصنوعی تا ۳ ماهه چهارم ۲۰۲۵به تقریباً ۲۹.۶گیگاوات رسید، که برای تأمین برق تمام ایالت نیویورک در اوج تقاضا کافی است (شکل ۱-۱۰). توان تراشه هوش مصنوعی، که با توان طراحی حرارتی اندازهگیری میشود، تقریباً ۱۱.۸گیگاوات از کل را تشکیل میدهد و مابقی آن به خنککننده، شبکه و سایر زیرساختهای مرکز داده نسبت داده میشود. این تخمین براساس ظرفیت برق نامی تراشههای هوش مصنوعی پیشرو فروخته شده در طول زمان است، با ضریب تقریبی ۲.۵که برای درنظر گرفتن نیازهای اضافی زیرساختهای برق اعمال میشود.
۳- مراکز داده
زیرساخت فیزیکی، زیربنای توسعه هوش مصنوعی فراتر از مدلها و محاسبات شرح داده شده در بخش قبلی است. مراکز داده جایی هستند که محاسبات در آن قرار میگیرند و ظرفیت، توزیع جغرافیایی و زنجیرههای تأمین زیربنایی آنها، نوع سیستمهای هوش مصنوعی قابل ساخت و محل آنها را تعیین میکند. این بخش، از دادههای Cloudcene برای ردیابی توزیع جهانی مراکز داده استفاده میکند و مروری بر اکوسیستم زیرساخت هوش مصنوعی گستردهتر ارائه میدهد تا زمینهای برای پویایی جغرافیایی و زنجیره تأمین فراهم کند.
۳-۱زیرساخت هوش مصنوعی: فراتر از پردازندههای گرافیکی
مراکز داده مدرن هوش مصنوعی به ترکیبی از محاسبات، ذخیرهسازی، ارتباطات و سختافزارهای تخصصی وابسته هستند که سیستمهای هوش مصنوعی را قادر میسازد در مقیاس بزرگ اجرا شوند. پردازندههای گرافیکی و شتابدهندههای سفارشی مانند واحدهای پردازش تنسور (TPU) بیشترین بحث را بهخود اختصاص دادهاند، اما آنها تنها یک لایه از یک پشته زیرساختی گستردهتر هستند. تمام دادههای پردازش شده توسط این تراشهها در حافظه با پهنای باند بالا (HBM) نگهداری میشوند که از انتقال حجم زیادی از دادهها به داخل و خارج بهطور کارآمد پشتیبانی میکند. تولیدکنندگان پیشرو HBM عبارتند از SK Hynix (کرهجنوبی)، سامسونگ (کرهجنوبی) و میکرون (ایالات متحده آمریکا). در طول آموزش، پردازندههای گرافیکی باید بهطور مداوم دادهها را با یکدیگر به اشتراک بگذارند، که نیاز به اتصال شبکه سریع و با توان بالا دارد که با کابلهای فیبر نوری که معماریهای شبکه با پهنای باند بالا مانند InfiniBand را اجرا میکنند، حاصل میشود. زنجیره تأمین پشت این سختافزار، بُعد دیگری را اضافه میکند. شرکتهایی مانند انویدیا و SK Hynix تراشهها را طراحی میکنند اما تولید نمیکنند. در عوض، آنها طرحهایی را به کارخانههای ریختهگری نیمههادی تخصصی، عمدتاً شرکت تولیدی نیمههادی تایوان (TSMC) و سامسونگ ریختهگری، ارائه میدهند که تراشهها را در مقیاس نانومتری مورد نیاز سختافزار هوش مصنوعی مدرن تولید میکنند. تراشههای ساخته شده سپس توسط شرکتهای مونتاژ مانند گروه ASE (تایوان) و Amkor Technology (ایالات متحده) بستهبندی و آزمایش میشوند. TSMC یک نقطه وابستگی واحد در زنجیره تأمین جهانی هوش مصنوعی است، زیرا تقریباً هر تراشه هوش مصنوعی پیشرو، ازجمله پردازندههای گرافیکی Blackwell انویدیا و MI300X AMD را تولید میکند. موانع زیادی برای ورود در هر لایه وجود دارد – که برای غلبه بر آنها به دههها تخصص انباشته، تجهیزات تخصصی و سرمایهگذاری قابل توجه نیاز است.
۳-۲توزیع جغرافیایی
بیشتر زیرساختهای مراکز داده جهان در تعداد کمی از کشورها قرار دارد (شکلهای ۱-۱۱و ۱-۱۲). در سال ۲۰۲۵، ایالات متحده با ۵۴۲۷ مرکز داده، بیش از ۱۰ برابر تعداد هر کشور دیگری، با اختلاف زیادی پیشتاز بود. آلمان (۵۲۹)، بریتانیا (۵۲۳) و چین (۴۴۹) پس از آن قرار گرفتند، درحالیکه اکثر کشورهای باقیمانده هر کدام کمتر از ۳۰۰ مرکز داشتند. ایالات متحده ممکن است پیشتازی آشکاری نشان دهد، اما رتبهبندی سایر کشورها باید با این درک ارزیابی شود که تعداد مراکز داده، تفاوتها در اندازه تأسیسات، ظرفیت محاسباتی یا میزان استفاده را در بر نمیگیرد.
۳- مراکز داده
زیرساخت فیزیکی، زیربنای توسعه هوش مصنوعی فراتر از مدلها و محاسبات شرح داده شده در بخش قبلی است. مراکز داده جایی هستند که محاسبات در آن قرار میگیرند و ظرفیت، توزیع جغرافیایی و زنجیرههای تأمین زیربنایی آنها، نوع سیستمهای هوش مصنوعی قابل ساخت و محل آنها را تعیین میکند. این بخش، از دادههای Cloudcene برای ردیابی توزیع جهانی مراکز داده استفاده میکند و مروری بر اکوسیستم زیرساخت هوش مصنوعی گستردهتر ارائه میدهد تا زمینهای برای پویایی جغرافیایی و زنجیره تأمین فراهم کند.
۳-۱زیرساخت هوش مصنوعی: فراتر از پردازندههای گرافیکی
مراکز داده مدرن هوش مصنوعی به ترکیبی از محاسبات، ذخیرهسازی، ارتباطات و سختافزارهای تخصصی وابسته هستند که سیستمهای هوش مصنوعی را قادر میسازد در مقیاس بزرگ اجرا شوند. پردازندههای گرافیکی و شتابدهندههای سفارشی مانند واحدهای پردازش تنسور (TPU) بیشترین بحث را بهخود اختصاص دادهاند، اما آنها تنها یک لایه از یک پشته زیرساختی گستردهتر هستند. تمام دادههای پردازش شده توسط این تراشهها در حافظه با پهنای باند بالا (HBM) نگهداری میشوند که از انتقال حجم زیادی از دادهها به داخل و خارج بهطور کارآمد پشتیبانی میکند. تولیدکنندگان پیشرو HBM عبارتند از SK Hynix (کرهجنوبی)، سامسونگ (کرهجنوبی) و میکرون (ایالات متحده آمریکا). در طول آموزش، پردازندههای گرافیکی باید بهطور مداوم دادهها را با یکدیگر به اشتراک بگذارند، که نیاز به اتصال شبکه سریع و با توان بالا دارد که با کابلهای فیبر نوری که معماریهای شبکه با پهنای باند بالا مانند InfiniBand را اجرا میکنند، حاصل میشود. زنجیره تأمین پشت این سختافزار، بُعد دیگری را اضافه میکند. شرکتهایی مانند انویدیا و SK Hynix تراشهها را طراحی میکنند اما تولید نمیکنند. در عوض، آنها طرحهایی را به کارخانههای ریختهگری نیمههادی تخصصی، عمدتاً شرکت تولیدی نیمههادی تایوان (TSMC) و سامسونگ ریختهگری، ارائه میدهند که تراشهها را در مقیاس نانومتری مورد نیاز سختافزار هوش مصنوعی مدرن تولید میکنند. تراشههای ساخته شده سپس توسط شرکتهای مونتاژ مانند گروه ASE (تایوان) و Amkor Technology (ایالات متحده) بستهبندی و آزمایش میشوند. TSMC یک نقطه وابستگی واحد در زنجیره تأمین جهانی هوش مصنوعی است، زیرا تقریباً هر تراشه هوش مصنوعی پیشرو، ازجمله پردازندههای گرافیکی Blackwell انویدیا و MI300X AMD را تولید میکند. موانع زیادی برای ورود در هر لایه وجود دارد – که برای غلبه بر آنها به دههها تخصص انباشته، تجهیزات تخصصی و سرمایهگذاری قابل توجه نیاز است.
۳-۲توزیع جغرافیایی
بیشتر زیرساختهای مراکز داده جهان در تعداد کمی از کشورها قرار دارد (شکلهای ۱-۱۱و ۱-۱۲). در سال ۲۰۲۵، ایالات متحده با ۵۴۲۷ مرکز داده، بیش از ۱۰ برابر تعداد هر کشور دیگری، با اختلاف زیادی پیشتاز بود. آلمان (۵۲۹)، بریتانیا (۵۲۳) و چین (۴۴۹) پس از آن قرار گرفتند، درحالیکه اکثر کشورهای باقیمانده هر کدام کمتر از ۳۰۰ مرکز داشتند. ایالات متحده ممکن است پیشتازی آشکاری نشان دهد، اما رتبهبندی سایر کشورها باید با این درک ارزیابی شود که تعداد مراکز داده، تفاوتها در اندازه تأسیسات، ظرفیت محاسباتی یا میزان استفاده را در بر نمیگیرد
۴- انرژی و تأثیر زیستمحیطی
با گسترش سیستمهای هوش مصنوعی، مصرف انرژی و اثرات زیستمحیطی آنها بسیار مشهود شده است. روندهای محاسباتی و زیرساختی که در بخشهای قبلی توضیح داده شد، به تقاضای سنگین برای انرژی، آب و انتشار کربن تبدیل میشوند. این بخش این هزینهها را در ۳ حوزه توسعه هوش مصنوعی بررسی میکند: آموزش، استنتاج و مصرف انرژی مرکز داده. این تحلیل از دادههای سطح مدل Epoch AI، تحقیقات اخیر معیارسنجی دانشگاهی (Jegham و همکاران، ۲۰۲۵)، گزارش آژانس بینالمللی انرژی در مورد مراکز داده (IEA، ۲۰۲۵) گرفته شده است.
۴-۱آموزش
تراشههای پیشرو حدود ۱۰ برابر بیشتر از تراشههای موجود در یک دهه پیش، به ازای هر وات، محاسبات ارائه میدهند، که Nvidia B200و Google TPU v5e ازجمله کارآمدترین آنها هستند. با این حال، مدلها سریعتر از بهبود بهرهوری، مقیاسبندی شدهاند، بنابراین کل توان مورد نیاز برای آموزش سیستمهای مرزی همچنان در حال افزایش است.
مصرف کل توان برای مدلهای آموزشی از اوایل دهه ۲۰۱۰ چندین برابر افزایش یافته است. انتشار کربن ناشی از این فعالیتها بهشدت افزایش یافته است (شکل ۱-۱۳). AlexNet در سال ۲۰۱۲ تخمیناً معادل ۰.۰۱ تن CO2تولید کرد، درحالیکه Grok4در سال ۲۰۲۵ حدود ۷۲۸۱۶ تن تولید کرد. برای روشن شدن موضوع، این مقدار بیشتر از میزان انتشار کربن در طول عمر یک ماشین متوسط (۶۳ تن) است.
مدلهای بزرگتر معمولاً انتشار بیشتری تولید میکنند، اما نه همیشه، زیرا این امر میتواند به راندمان سختافزار، مدت زمان آموزش و شدت کربن منابع انرژی مورد استفاده نیز بستگی داشته باشد. بهعنوان مثال، DeepSeek v3تقریباً ۵۹۷ تن تولید کرد که بسیار کمتر از مدلهای با اندازه قابل مقایسه است (شکل ۱-۱۴).
۴-۲استفاده از مرکز داده
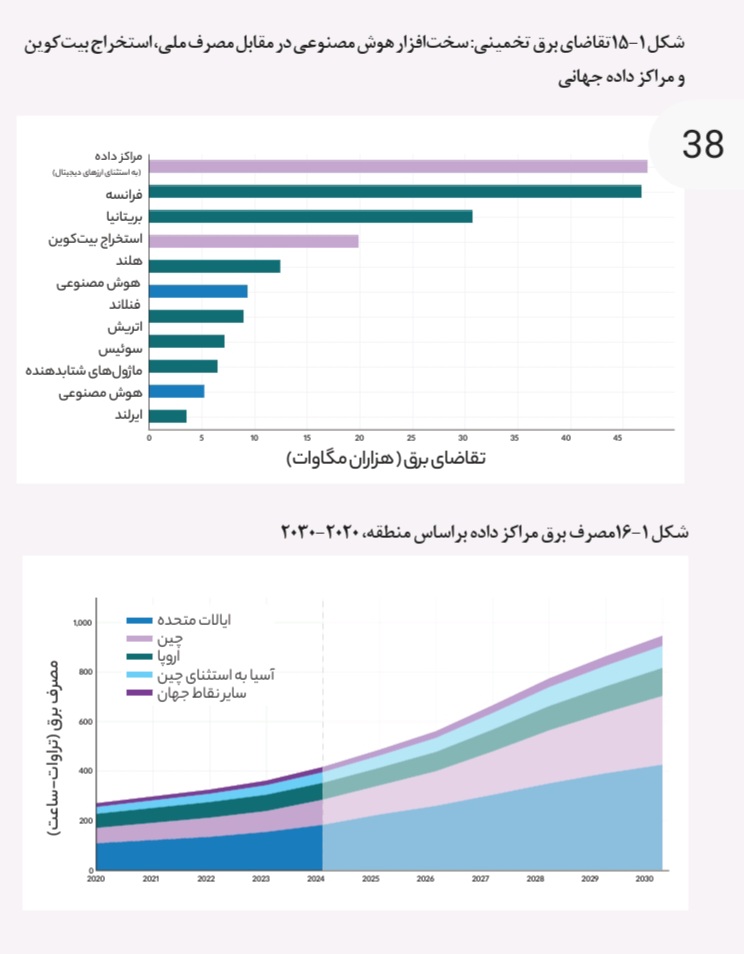
تقاضای برق تخمینی از ماژولهای شتابدهنده هوش مصنوعی تا سال ۲۰۲۴بهطور تجمعی تقریباً به ۵۲۰۰مگاوات رسید. انویدیا بیشترین سهم را بهخود اختصاص داده است، که با موقعیت پیشرو این شرکت در ظرفیت تراشه هوش مصنوعی جهانی سازگار است. با احتساب سیستمهای کامل پشتیبانیکننده از این شتابدهندهها (سرورها، خنککننده، شبکه)، تقاضای تخمینی تقریباً به ۹۴۰۰مگاوات رسید.
برای درک بهتر این مقیاس، تقاضای برق تجمعی سیستمهای هوش مصنوعی کامل با مصرف برق ملی سوئیس یا اتریش و تقریباً نیمی از مصرف برق استخراج بیت کوین قابل مقایسه است (شکل ۱-۱۵). به استثنای ارزهای دیجیتال، مراکز داده جهانی بالاترین تقاضای برق تخمینی را با حدود ۴۷۰۰۰ مگاوات بهخود اختصاص دادهاند و سختافزار هوش مصنوعی سهم فزایندهای از این کل را تشکیل میدهد.
با این حال، هزینه در جهت مخالف حرکت کرده است. از سال ۲۰۰۶، هزینه محاسبات GPU بیش از ۹۹درصد کاهش یافته است. این کاهش، آموزش و استقرار مدلها را در سطوحی که حتی یک دهه پیش از نظر هزینه گزاف بودند، از نظر اقتصادی امکانپذیر میسازد. در سطح منطقهای، مصرف برق مراکز داده در تمام مناطق اصلی افزایش یافته است و پیشبینی میشود که تا سال ۲۰۳۰ همچنان افزایش یابد (شکل ۱-۱۶). ایالات متحده بزرگترین سهم را بهخود اختصاص داده و پس از آن چین، اروپا و بقیه آسیا قرار دارند.
۵- مقالات و تحقیقات
این بخش به خروجی تحقیقات، بهویژه انتشارات و استنادهای هوش مصنوعی به زبان انگلیسی، میپردازد. انتشارات، سیگنالی طولی از فعالیت تحقیقاتی هوش مصنوعی در مقیاس بزرگ ارائه میدهند و شاخص هوش مصنوعی آنها را بهطور مداوم در طول زمان پیگیری کرده است. درحالیکه حجم انتشارات معیاری برای کیفیت تحقیقات نیست و همه تحقیقات در پایگاههای داده فهرستبندیشده ظاهر نمیشوند، این رویکرد روشی ثابت برای ردیابی مرز تحقیقات سال به سال ارائه میدهد. این تحلیل از OpenAlex، یک پایگاه داده کتابشناختی که شاخص هوش مصنوعی از سال ۲۰۲۵از آن استفاده کرده است، گرفته شده است و هم حجم انتشارات و هم تأثیر پاییندستی را از طریق الگوهای استناد درنظر میگیرد.
۵-۱تعداد کل انتشارات هوش مصنوعی
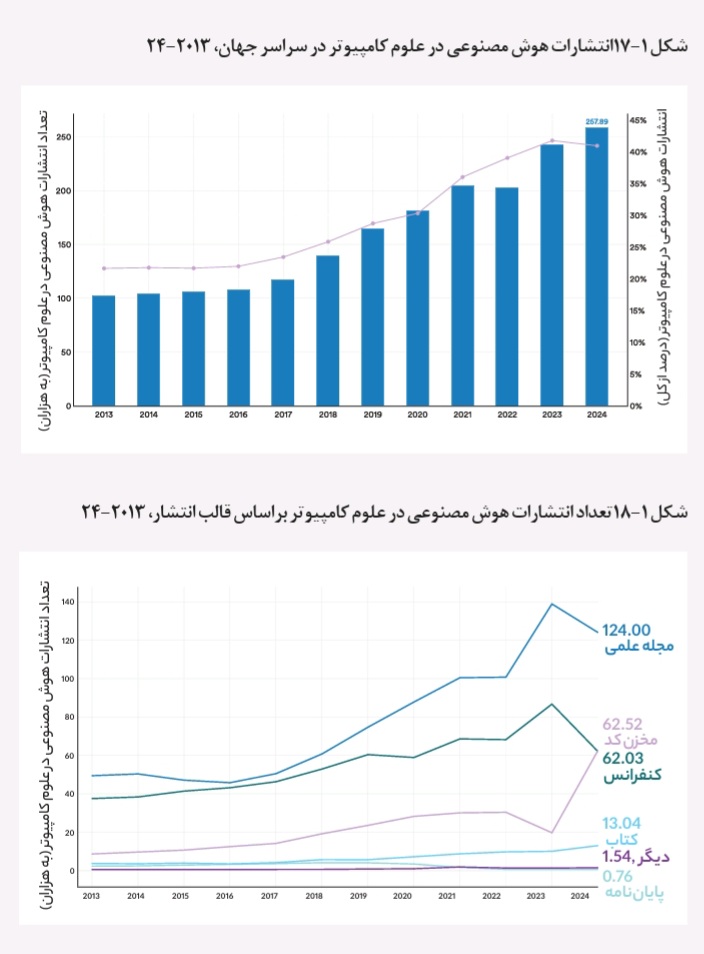
مجموع انتشارات هوش مصنوعی همچنان در حال افزایش است. انتشارات هوش مصنوعی بین سالهای ۲۰۱۳ تا ۲۰۲۴ بیش از دو برابر شده و از تقریباً ۱۰۲۰۰۰ به حدود ۲۵۸۰۰۰ افزایش یافته است (شکل ۱-۱۷). این رشد در سال ۲۰۲۴ نیز ادامه یافت، هرچند با سرعت کمتری و انتشارات نسبت به سال ۲۰۲۳، ۶.۳ درصد افزایش یافت. تحقیقات هوش مصنوعی اکنون بخش قابلتوجهی از اکوسیستم گستردهتر علوم کامپیوتر معادل ۴۰.۹ درصد از کل انتشارات علوم کامپیوتر در OpenAlex را تشکیل میدهد.
۵-۲براساس قالب انتشار
در سال ۲۰۲۴، مجلات بیشترین سهم از انتشارات هوش مصنوعی (۶۲.۸درصد) و پس از آن کنفرانسها (۲۳.۸درصد) را بهخود اختصاص دادند (شکل ۱-۱۸). از سال ۲۰۱۳، تعداد مطلق انتشارات مجلات و کنفرانسها افزایش یافته است، اگرچه سهم نسبی آنها تغییر کرده است. نسبت مقالات هوش مصنوعی که در کنفرانسها منتشر میشوند، از ۳۶.۶درصد در سال ۲۰۱۳به سطح فعلی خود بهطور پیوسته کاهش یافته است.
۵-۳براساس وابستگی ملی
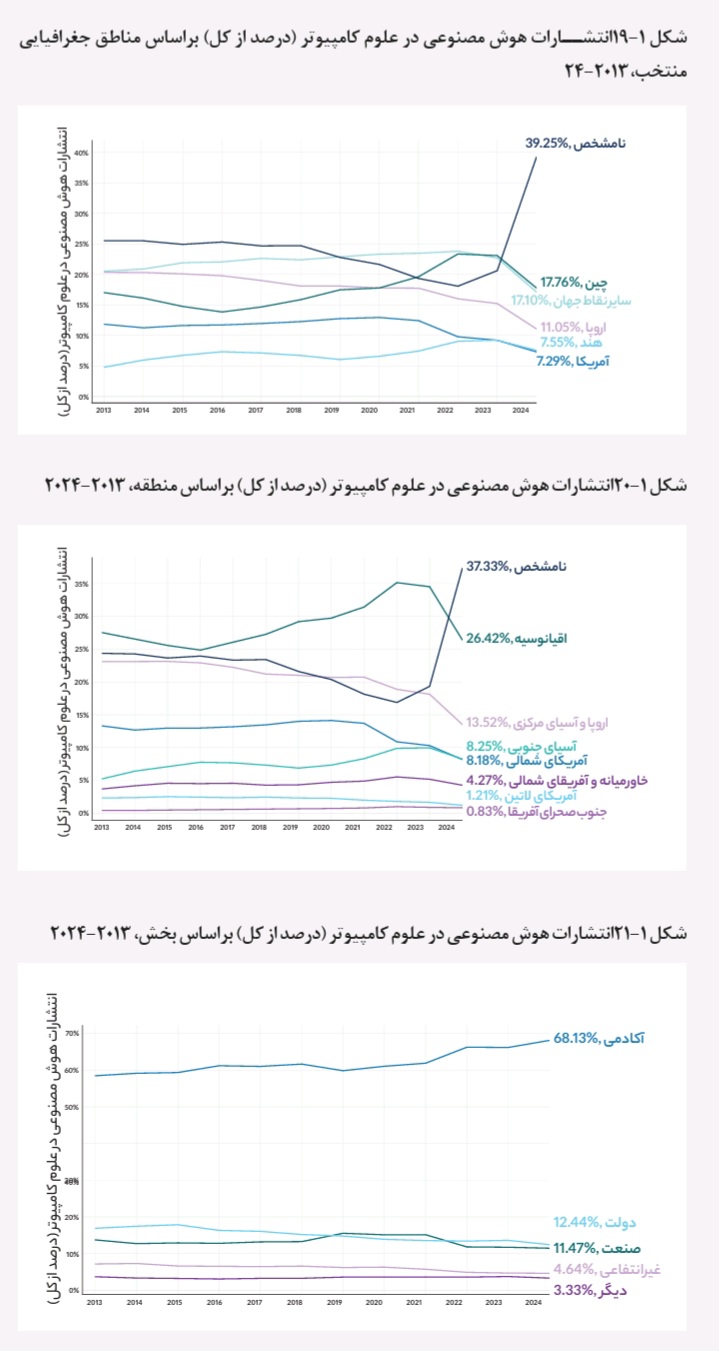
در سال ۲۰۲۴، چین ۱۷.۸درصد از انتشارات هوش مصنوعی در سال ۲۰۲۴را بهخود اختصاص داد، درحالیکه این رقم برای اروپا ۱۱.۱درصد و برای هند ۷.۶درصد بود (شکل ۱-۱۹). انتشارات هوش مصنوعی چین همچنین ۲۰.۶درصد از کل استنادهای هوش مصنوعی در سال ۲۰۲۴را بهخود اختصاص داد و پس از آن اروپا با ۱۹.۵درصد و ایالات متحده با ۱۲.۶درصد قرار گرفتند (شکل ۱-۲۰). ایالات متحده شاهد کاهش ۳درصدی در سهم انتشارات بود، اگرچه سهم استناد آن نسبتاً بدون تغییر باقی ماند (۱۲.۶درصد در سال ۲۰۲۴در مقابل ۱۳.۰۳درصد در سال ۲۰۲۳). سهم «نامشخص» در دادههای انتشارات در سال ۲۰۲۴به ۳۹.۳درصد افزایش یافت، افزایشی که احتمالاً نشاندهنده تغییرات در پوشش فراداده است. توزیع جغرافیایی انتشارات و استنادها، زمینه را برای روندهای مورد بحث در اوایل بخش فراهم میکند، جایی که تعداد نسبتاً کمی از کشورها سهم نامتناسبی از فعالیت را بهخود اختصاص میدهند.
۵-۴براساس بخش
دانشگاهها اکثر انتشارات هوش مصنوعی را در سال ۲۰۲۴تولید کردند (۶۸.۱درصد)، پس از آن مؤسسات دولتی (۱۲.۴درصد)، صنعت (۱۱.۵درصد) و سازمانهای غیرانتفاعی (۴.۶درصد) قرار داشتند (شکل ۱-۲۱). تفکیک بخشها براساس منطقه متفاوت است. در ایالات متحده، سهم بیشتری از انتشارات هوش مصنوعی از صنعت (۲۴.۶درصد) در مقایسه با چین (۱۸درصد) حاصل شد، جایی که مؤسسات دولتی مشارکت معنادارتری داشتند (۲۵.۱درصد). اروپا بالاترین درصد انتشارات هوش مصنوعی را که از دانشگاهها سرچشمه میگرفت، داشت (۵۵.۳درصد).
۵-۵براساس موضوع
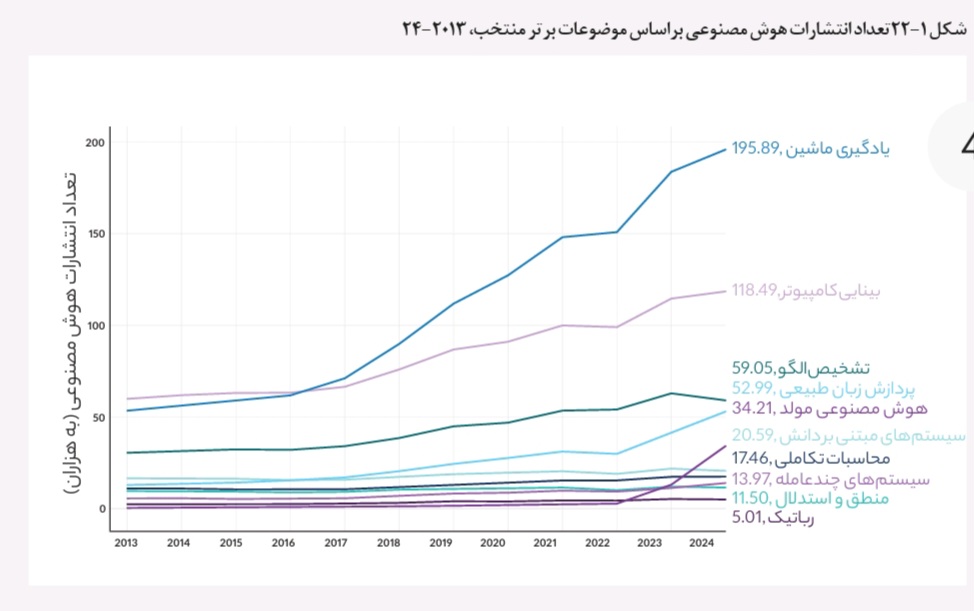
تحقیقات هوش مصنوعی در سال ۲۰۲۴همچنان در مجموعه کوچکی از موضوعات اصلی متمرکز بود، اگرچه وسعت حوزهها همچنان در حال گسترش بود. مشابه سال قبل، رایجترین موضوع تحقیقاتی یادگیری ماشین (۳۷درصد) و پس از آن بینایی کامپیوتر (۲۲.۴درصد)، تشخیص الگو (۱۱.۲درصد) و پردازش زبان طبیعی (۱۰درصد) بود (شکل ۱-۲۲). انتشارات در مورد هوش مصنوعی مولد همچنان رشد شدیدی را نشان داده و روند رو به رشد سالهای گذشته را ادامه میدهد.
۵-۶صد نشریه برتر
گزارش شاخص هوش مصنوعی، ۱۰۰ نشریه پراستناد هوش مصنوعی را از سال ۲۰۲۱ تا ۲۰۲۴ با استفاده از دادههای استنادی OpenAlex شناسایی کرد. بهدلیل تأخیر استنادی، این مجموعه میتواند با تجمع استنادها در طول زمان تغییر کند. دادههای حجم انتشار بالا، مقیاس فعالیت تحقیقاتی را نشان میدهد، درحالیکه ۱۰۰ نشریه برتر، دیدگاه گزینشیتری در مورد اینکه کدام کار بیشترین شناخت و نفوذ را بهدست میآورد، ارائه میدهد.
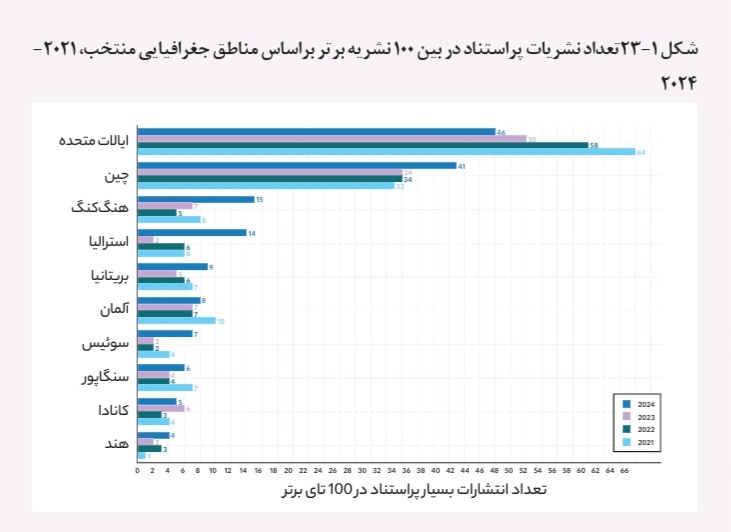
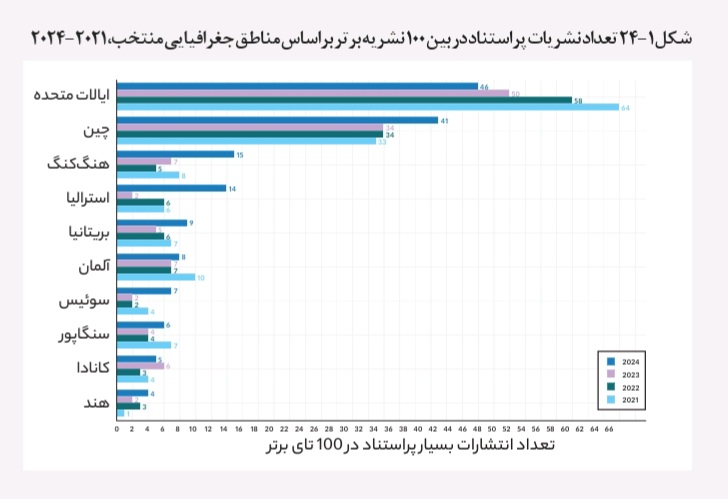
براساس وابستگی ملی: توزیع جغرافیایی ۱۰۰ نشریه برتر در طول زمان تغییر کرده است (شکل ۱-۲۳). ایالات متحده هنوز هم هر ساله بالاترین رتبه را در بین نشریات پراستناد دارد، اگرچه سهم آن بهتدریج از ۶۴ در سال ۲۰۲۱ به ۴۶ در سال ۲۰۲۴ کاهش یافته است. سهم چین از ۳۴ در سال ۲۰۲۳ به ۴۱ در سال ۲۰۲۴ افزایش یافته است و استرالیا به ۱۴ نشریه پراستناد افزایش یافته است که از ۲ در سال ۲۰۲۳ به ۶ در سال ۲۰۲۱ افزایش یافته است.
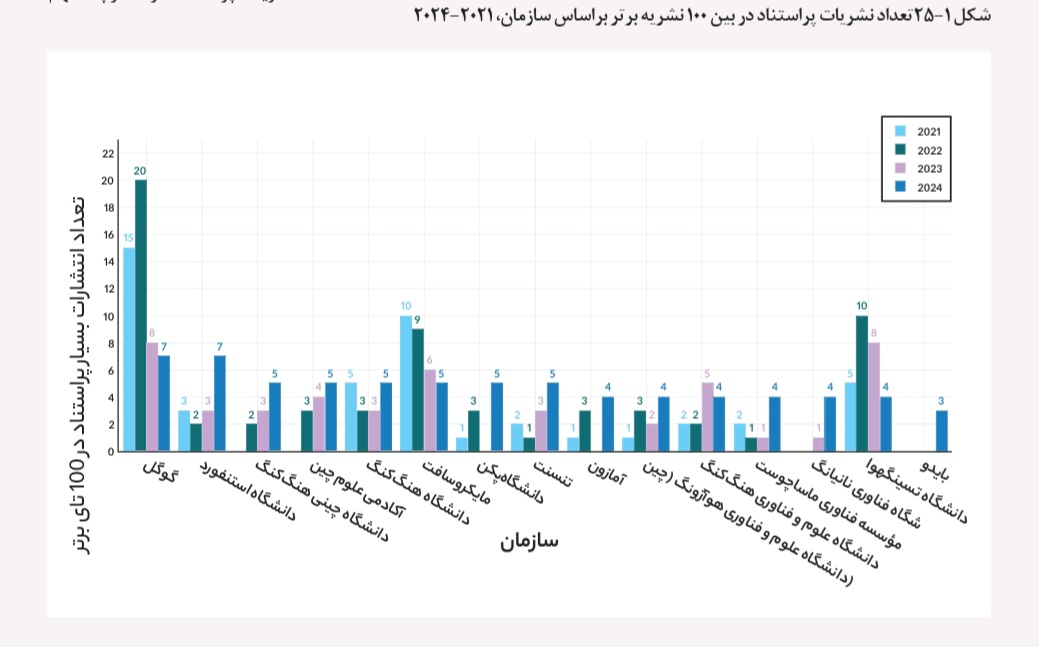
براساس بخش و سازمان: ترکیب بخشهای ۱۰۰ دانشگاه برتر ثابت باقی ماند، بهطوری که دانشگاهها بیشترین انتشارات پراستناد را در طول سال تولید کردند (شکل ۱-۲۴). سهم صنعت از ۱۷ در سال ۲۰۲۱ و ۱۹ در سال ۲۰۲۲ به ۶ در سال ۲۰۲۴ بهشدت کاهش یافت، حتی با اینکه سهم صنعت از انتشار مدلهای قابل توجه همچنان در حال افزایش است (بخش ۱.۱). توزیع سازمانی براساس سال متفاوت است، اگرچه خروجی همچنان در بین مجموعه کوچکی از مؤسسات متمرکز است (شکل ۱-۲۵).
در سال ۲۰۲۴، دانشگاه استنفورد و گوگل هر کدام با ۷ انتشارات پیشتاز بودند و آکادمی علوم چین و مایکروسافت هر کدام با ۵ انتشارات، از نزدیک در پی آنها بودند.
۶- اختراعات
درحالیکه انتشارات، خروجیهای تحقیقاتی را دنبال میکنند، اختراعات بینشی در مورد نوآوری کاربردی و توسعه تجاری ارائه میدهند. این بخش به بررسی روندهای ثبت اختراعات جهانی هوش مصنوعی در طول زمان میپردازد. اختراعات میتوانند دریچه دیگری برای ردیابی نوآوری در سازمانها و مناطق جغرافیایی، بهویژه در زمینههای کاربردی هوش مصنوعی، فراهم کنند. مشابه دادههای انتشارات، تأخیرهای قابل توجهی قبل از در دسترس قرار گرفتن دادههای ثبت اختراع هوش مصنوعی وجود دارد، و سال ۲۰۲۴آخرین سالی است که در دسترس قرار گرفته است. این تحلیل از سوابق کتابشناختی سطح اختراع در PATSTAT Global، یک پایگاه داده جامع ارائه شده توسط دفتر ثبت اختراع اروپا (EPO) گرفته شده است.
۶-۱روندهای جهانی
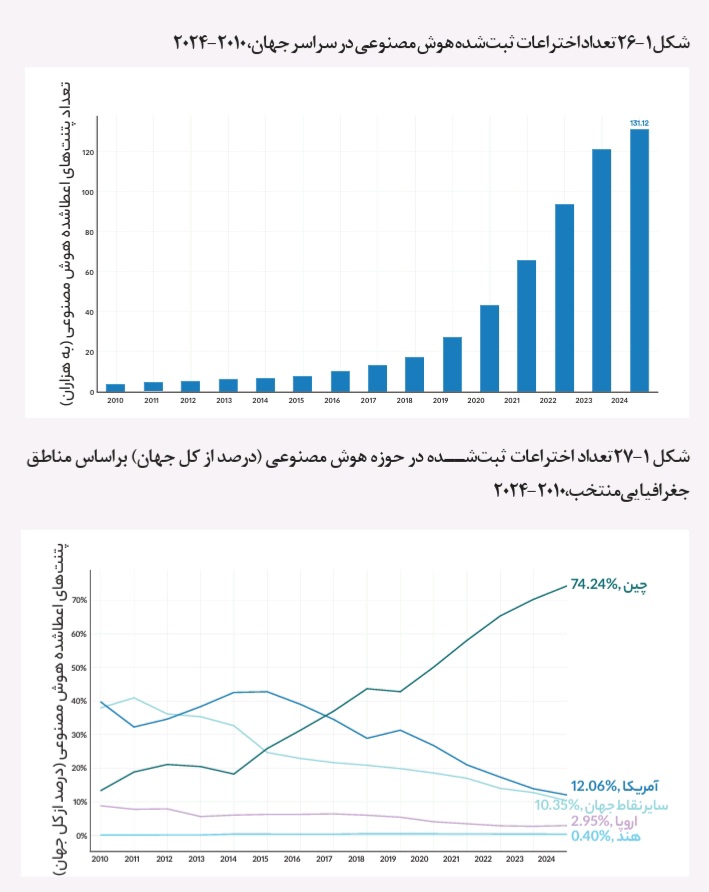
در سطح جهانی، تعداد اختراعات ثبت شده هوش مصنوعی بهصورت تصاعدی افزایش یافته است، از ۳۸۶۶در سال ۲۰۱۰به ۱۳۱۱۲۱در سال ۲۰۲۴(شکل ۱-۲۶). بین سالهای ۲۰۲۳و ۲۰۲۴، اعطای حق ثبت اختراع ۸.۲درصد افزایش یافته است. چین با ۷۴.۲درصد از کل جهان، اکثریت را بهخود اختصاص داده است (شکل ۱-۲۷). ایالات متحده با ۱۲.۱درصد (۱۵۲۹۰ اختراع ثبت شده) سهم عمده بعدی را دارد و پس از آن اروپا (۳درصد) و هند (۰.۴درصد) قرار دارند. در طول دهه گذشته، سهم ایالات متحده از اوج ۴۲.۸درصد در سال ۲۰۱۵ بهطور پیوسته کاهش یافته است، درحالیکه سهم چین از زیر ۲۰درصد به سطح فعلی خود افزایش یافته است. اختراعات و انتشارات، مراحل مختلفی را در خط لوله تحقیق و توسعه نشان میدهند، بنابراین پیشتازی چین در هر دو، اگرچه بهطور مستقیم با هم مرتبط نیستند، اما با حضور رو به رشد تحقیقاتی این کشور که قبلاً توضیح داده شد، سازگار است.
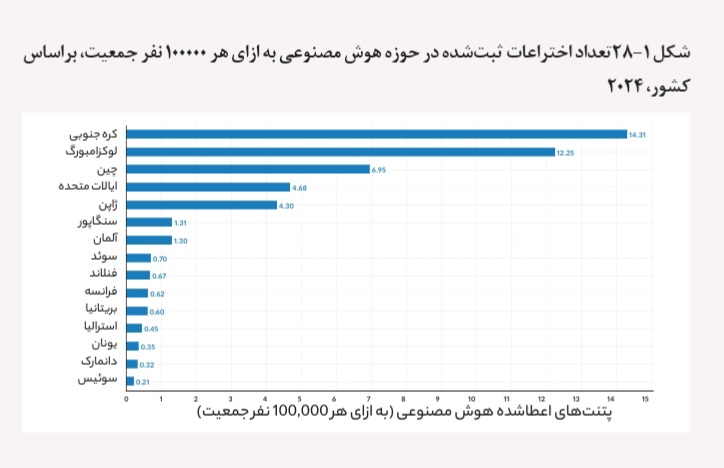
سایر رهبران منطقهای زمانی ظاهر میشوند که فعالیت اختراعات براساس اندازه جمعیت نرمال شود (شکل ۱-۲۸). در سال ۲۰۲۴، کرهجنوبی بیشترین تعداد اختراعات ثبتشده هوش مصنوعی را براساس سرانه (۱۴.۳درصد) داشت و پس از آن لوکزامبورگ (۱۲.۳درصد) و چین (۷.۰درصد) قرار گرفتند.
۶-۲نزدیکی فناوری (Technological Proximity)
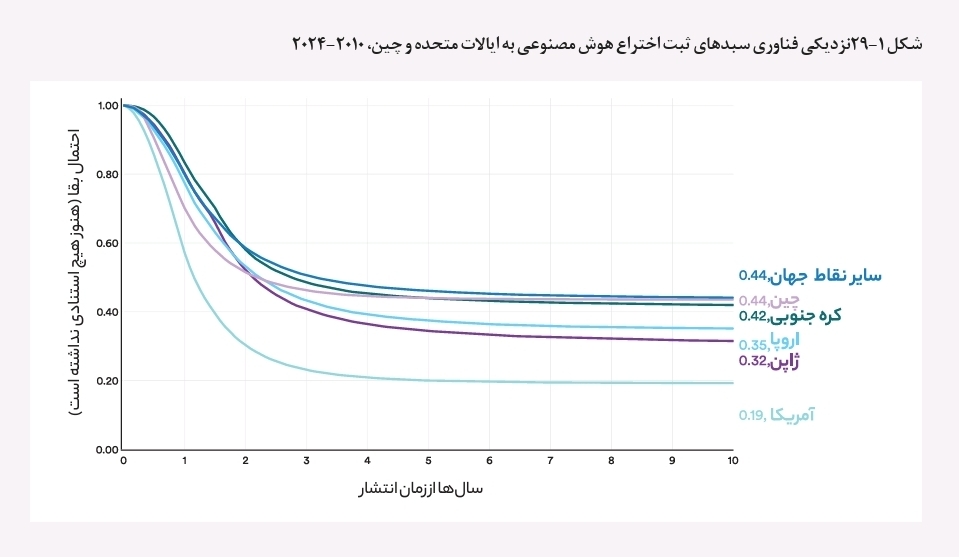
«نزدیکی فناوری» اندازهگیری میکند که آیا کشورها در انواع مشابهی از نوآوری هوش مصنوعی همگرا هستند یا مسیرهای متمایزی را دنبال میکنند. با استفاده از روشی که توسط بار و همکاران(۲۰۱۲) پیشنهاد شده است، این تحلیل مقایسه میکند که سبد اختراعات هوش مصنوعی هر کشور چقدر با دو نقطه مرجع بزرگ، ایالات متحده و چین، همسو است (شکل ۱-۲۹). همپوشانی در مقیاسی از صفر (بدون شباهت) تا یک (یکسان) امتیازدهی میشود. اکثر کشورها در بالا سمت راست جمع میشوند، به این معنی که اختراعات هوش مصنوعی آنها حوزههای فناوری مشابهی را با ایالات متحده و چین پوشش میدهد، با تمایل بیشتر به سبد اختراعات ایالات متحده. بهعنوان مثال، هند و استرالیا سبد اختراعاتی دارند که نزدیک به ۸۰درصد با هر دو همپوشانی نشان میدهد. دانمارک کمترین شباهت را به هر دو نقطه مرجع دارد و تنها ۴۵درصد با چین و ۵۲درصد با ایالات متحده همپوشانی دارد. دلیل این امر این است که اختراعات هوش مصنوعی دانمارک در دستههای فناوری مرتبط با انرژی و باد متمرکز شدهاند، نه در دستههای اصلی محاسبات و پردازشداده که هم در ایالات متحده و هم در چین غالب هستند. درحالیکه سبد نوآوری هوش مصنوعی اکثر کشورها ساختار مشابهی دارد، نقاط قوت صنعتی ملی تمایل دارند بر محل کاربرد هوش مصنوعی تأثیر بگذارند.
۷- نویسندگان و مخترعان هوش مصنوعی
انتشارات و اختراعات مورد بحث در بالا، خروجیهای تحقیق و توسعه را منعکس میکنند. با استفاده از دادههای Zeki، شاخص هوش مصنوعی، توزیع جغرافیایی و الگوهای تحرک نویسندگان و مخترعان پشت این کار را میتوان در طول زمان بررسی کرد. Zeki استعدادها را در خارج از چین براساس خروجیهای قابل مشاهده هوش مصنوعی مانند تحقیقات، مخازن داده و مدلهای جدید شناسایی میکند. این مجموعه دادهها، سالهای ۲۰۱۰تا ۲۰۲۵را در گروهی از کشورها در آمریکای شمالی، اروپا، آسیا، آمریکای لاتین و خاورمیانه پوشش میدهد.
۷-۱توزیع جغرافیایی
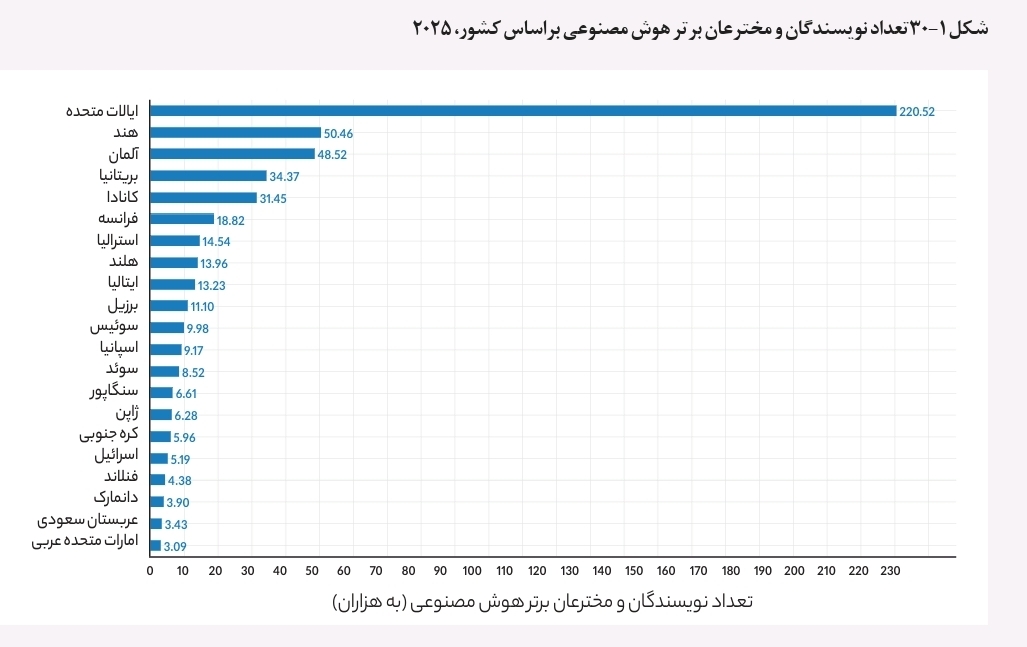
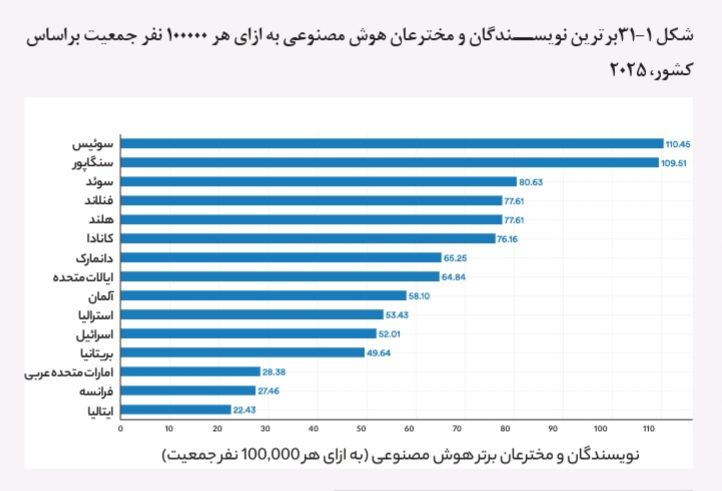
در سال ۲۰۲۵، بیشترین سهم نویسندگان و مخترعان شناسایی شده هوش مصنوعی از ایالات متحده (۲۲۰۵۲۰)، و پس از آن هند (۵۰۴۶۰) و آلمان (۴۸۵۲۰) بودند (شکل ۱-۳۰). بریتانیا (۳۴۳۷۰)، کانادا (۳۱۴۵۰) و فرانسه (۱۸۸۲۰) در رده دوم قرار گرفتند و استرالیا، هلند، ایتالیا، برزیل، سوئیس و سایر کشورها، توزیع گستردهتری از مشارکتکنندگان را تشکیل دادند. با نگاهی به دادهها براساس سرانه، کشورهایی را مشاهده میکنیم که سطح نسبتاً بالایی از فعالیت هوش مصنوعی دارند که هنگام بررسی حجم کل قابل مشاهده نیستند، همانطور که در دادههای سرانه ثبت اختراع در بخش قبلی مشاهده میشود. سوئیس با ۱۱۰.۵ نویسنده و مخترع هوش مصنوعی به ازای هر ۱۰۰۰۰۰ نفر جمعیت، در صدر قرار دارد و پس از آن سنگاپور (۱۰۹.۵) با اختلاف کمی قرار دارد (شکل ۱-۳۱). کشورهایی با جمعیت کمتر، مانند فنلاند (۷۷.۶)، هلند (۷۷.۶) و دانمارک (۶۶.۳)، بالاتر از کشورهای بزرگتر ازجمله آلمان (۵۸.۱) و بریتانیا (۴۹.۶) قرار دارند.
۷-۲براساس سطح تحصیلات
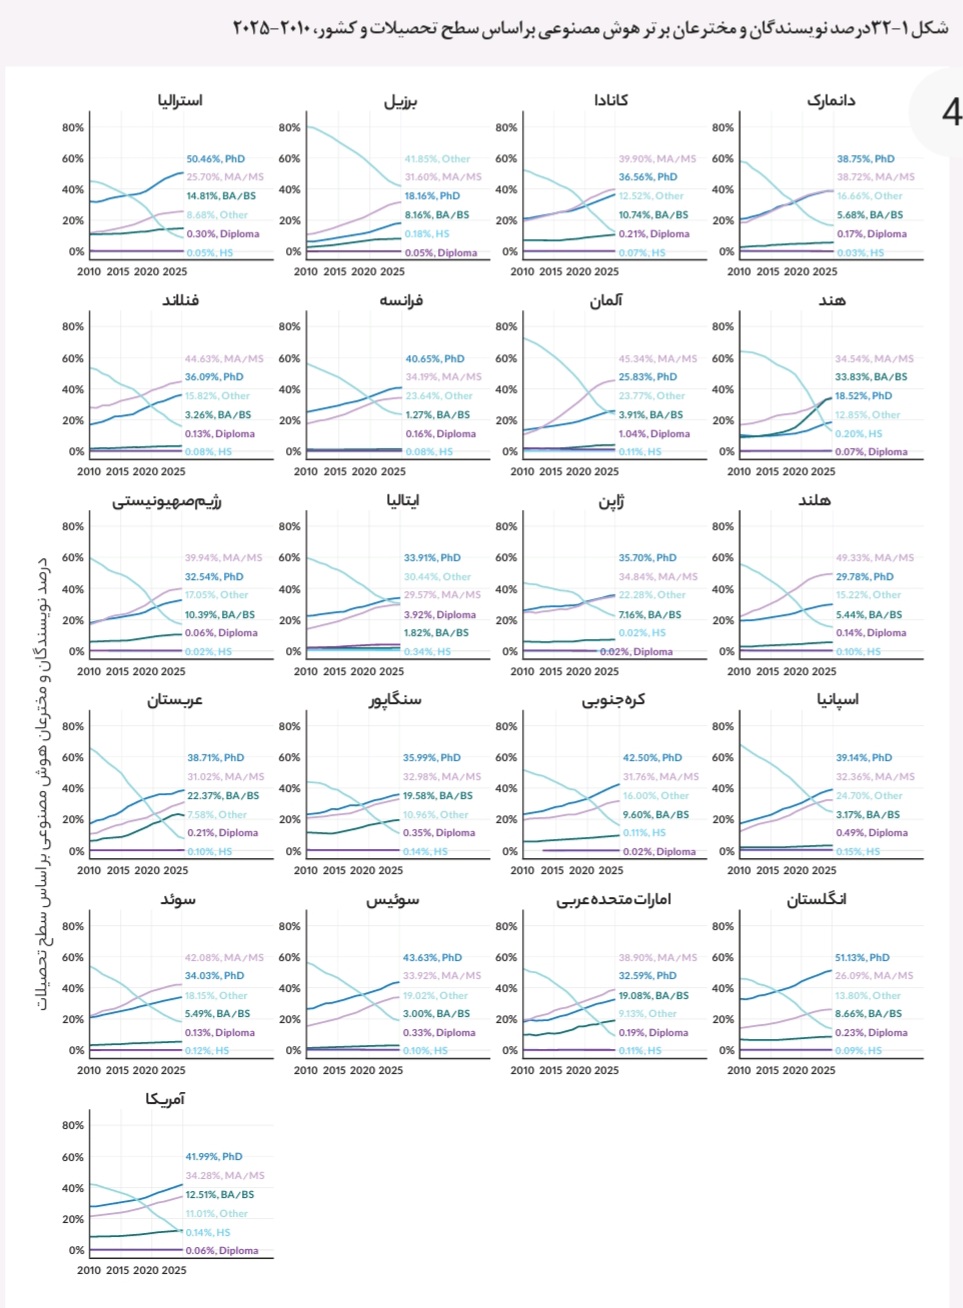
مشخصات تحصیلی نویسندگان و مخترعان برتر هوش مصنوعی براساس کشور متفاوت است، اگرچه در بیشتر کشورها، دارندگان مدرک دکتری و دارندگان مدرک کارشناسی ارشد در سال ۲۰۲۵اکثریت را تشکیل میدهند (شکل ۱-۳۲). بریتانیا (۵۱.۱درصد) و استرالیا (۵۰.۵درصد) بیشترین سهم دارندگان مدرک دکتری را دارند و پس از آنها سوئیس (۴۳.۶درصد)، کرهجنوبی (۴۲.۵درصد) و ایالات متحده (۴۲درصد) قرار دارند. هند و برزیل توزیع متنوعتری را نشان میدهند، با سهم نسبتاً کمتر دارندگان مدرک دکتری و پراکندگی بیشتر در سایر سطوح مدرک.
۷-۳براساس جنسیت
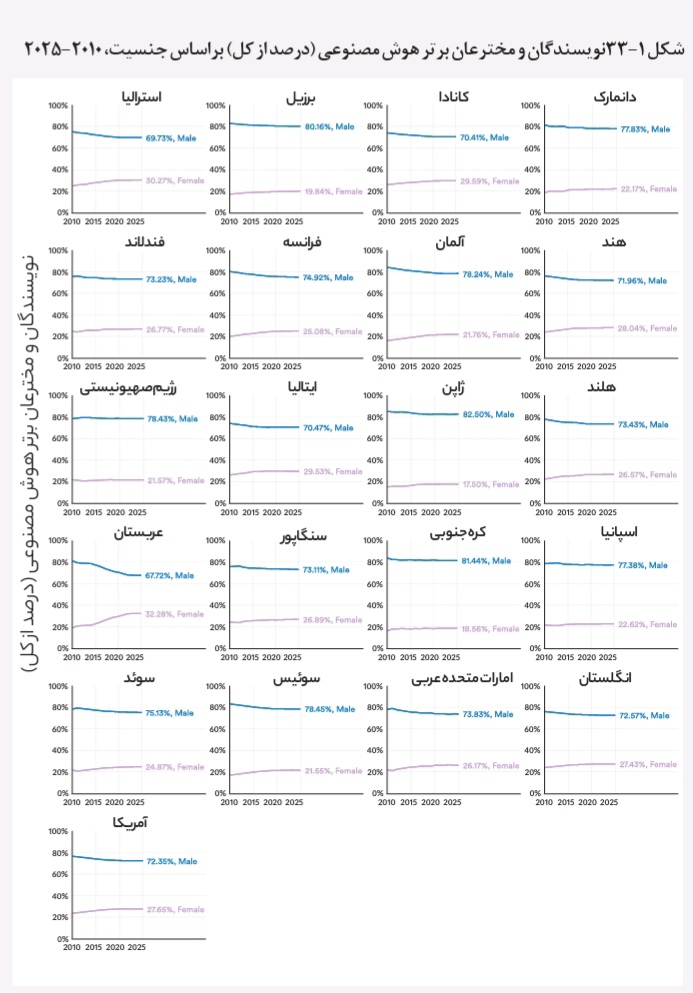
شکاف جنسیتی بین نویسندگان و مخترعان هوش مصنوعی در همه کشورها قابل مشاهده است و مردان در همه موارد اکثریت را تشکیل میدهند، اگرچه اندازه شکاف متفاوت است (شکل ۱-۳۳). در برزیل، کرهجنوبی و ژاپن، بیش از ۸۰درصد از استعدادهای شناساییشده هوش مصنوعی مرد هستند. حضور زنان در عربستان سعودی (۳۲.۳درصد)، استرالیا (۳۰.۱درصد)، کانادا (۲۹.۶درصد) و ایتالیا (۲۹.۵درصد) تا حدودی بیشتر است، اما هیچ کشوری به برابری نزدیک نمیشود. مهمتر از همه، تقریباً در هر کشور، نسبت زن و مرد از سال ۲۰۱۰تا ۲۰۲۵ثابت مانده است. حتی با رشد کلی استعدادهای هوش مصنوعی، هیچ پیشرفت معناداری در تعادل جنسیتی حاصل نشده است. بخش ۷(آموزش) الگوی مشابهی را در دستیابی به مدارک مرتبط با هوش مصنوعی توصیف میکند، که در آن زنان در تمام سطوح همچنان کمتر از حد انتظار حضور دارند.
۷-۴براساس تخصص
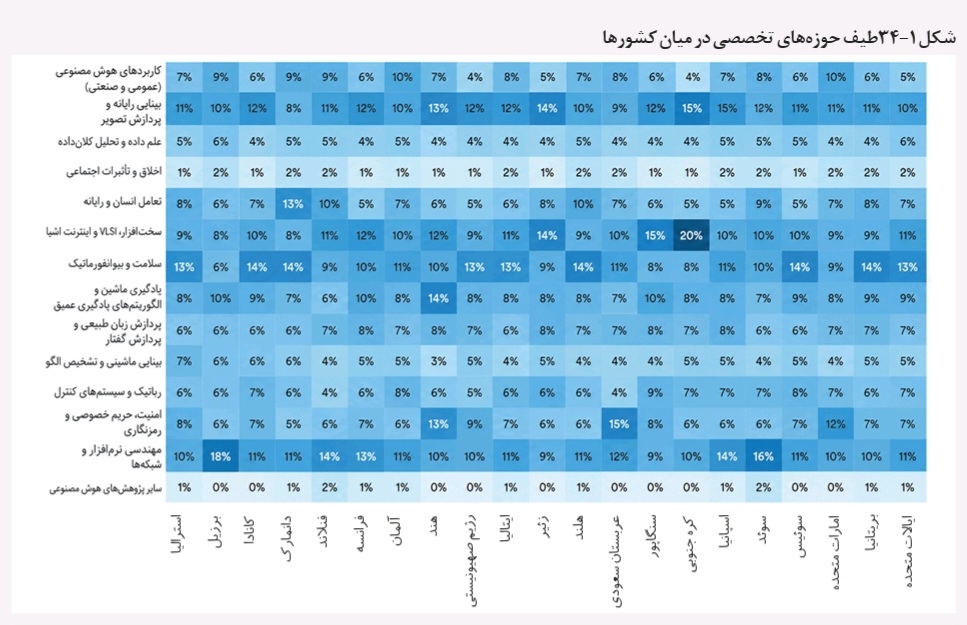
نویسندگان و مخترعان هوش مصنوعی طیف وسیعی از حوزههای تخصصی توزیعشدهاند، اگرچه هر کشور تأکید خاص خود را نشان میدهد (شکل ۱-۳۴). مراقبتهای بهداشتی و بیوانفورماتیک، بینایی کامپیوتر و پردازش تصویر و مهندسی نرمافزار ازجمله رایجترین حوزههای جهانی هستند که ۱۰درصد یا بیشتر از مجموعه را در چندین کشور تشکیل میدهند. چند الگوی سطح کشوری با یافتههای مورد بحث در اوایل این بخش مرتبط هستند.
بهعنوان مثال، کرهجنوبی بیشترین سهم استعداد را در سختافزار، VLSI و IoT (20درصد) دارد که با نقش آن در زنجیره تأمین نیمههادی سازگار است. برزیل بالاترین سهم استعداد مهندسی نرمافزار (۱۸درصد) را دارد، درحالیکه عربستان سعودی در امنیت، حریم خصوصی و رمزنگاری (۱۵درصد) پیشرو است.
۷-۵تحرک
تحرک از طریق جریان خالص اندازهگیری میشود، که تفاوت بین تعداد نویسندگان و مخترعان هوش مصنوعی است که به کشورهای خود نقل مکان میکنند یا از آنها خارج میشوند. ایالات متحده از سال ۲۰۲۰تاکنون مثبت خالص باقی مانده است، به این معنی که استعدادهای بیشتری را نسبت به آنچه از دست میدهد جذب میکند، اگرچه این میزان از اوج ۳۲۴.۶در سال ۲۰۲۲به ۲۶ در سال ۲۰۲۵کاهش یافته است. اکثر کشورهای دیگر در مقیاس کوچکتری فعالیت میکنند. عربستان سعودی (۳.۱) و دانمارک (۲.۱) از معدود کشورهایی بودند که جریان خالص سرمایهگذاری مثبت در سال ۲۰۲۵ داشتند. کانادا که در حدود سال ۲۰۲۰ جریان ورودی قوی را نشان میداد، تا سال ۲۰۲۵ به منفی ۷.۱ کاهش یافت. آلمان نیز جریان خالص منفی با منفی۲.۴ را نشان داد، درحالیکه هند بیشترین جریان خالص خروجی را با منفی۱۶.۹ در سال ۲۰۲۵ داشت. این جریانها در چارچوب عوامل دیگر، ازجمله سیاست مهاجرت و توزیع جغرافیایی با سرمایهگذاری و اشتغال مرتبط هستند.


دیدگاهتان را بنویسید