
به گزارش دانشمند، هوش مصنوعی مسئولانه (Responsible AI) در حال رشد است، اما پیشرفت ها فراز و نشیب زیادی داشته و با سرعت استقرار هوش مصنوعی همگام نیست. معیارهای ایمنی جدید گسترش یافتهاند، سازمانهای بیشتری سیاستهای مسئولانه هوش مصنوعی را اتخاذ میکنند و مؤسسات ایمنی و/یا امنیتی هوش مصنوعی تحت حمایت دولت در کشورهای بیشتری گسترش یافتهاند. استفاده مسئولانه از هوش مصنوعی با استفاده مسئولانه از دادهها و به ویژه با حریم خصوصی و سایر نگرانیهای قانونی در هم تنیده شده است. همچنین نگرانیهایی در مورد حاکمیت هوش مصنوعی با توجه به مالکیت نامشخص سیستمهای هوش مصنوعی وجود دارد که سوالاتی را در مورد اینکه آیا شرکتهایی که سیستمها را توسعه میدهند یا مصرفکنندگانی که آنها را خریداری میکنند باید پاسخگو باشند و هر ذینفع چه سیاستهایی را باید دنبال کند، مطرح میکند. در حالی که گزارشهای مستند از حوادث هوش مصنوعی در حال افزایش است، مدلهای مرزی به ندرت نتایج مربوط به معیارهای هوش مصنوعی مسئولانه را گزارش میدهند و شفافیت مدل بنیادی در سال ۲۰۲۵ پس از بهبود در سال قبل کاهش یافته است. تحقیقات اخیر نشان میدهد که بهبود یک بُعد هوش مصنوعیِ مسئولانه میتواند به قیمت از دست رفتن بُعد دیگر تمام شود، به طوری که افزایش در حریم خصوصی، انصاف را کاهش دهد یا افزایش در ایمنی، دقت را کاهش دهد. هیچ چارچوبی برای پیمایش این بدهبستانها وجود ندارد؛ و برای ابعادی مانند انصاف، حریم خصوصی و قابلیت توضیح، دادههای استاندارد شدهای که برای پیگیری پیشرفت در طول زمان مورد نیاز است، وجود ندارد.
نکات برجسته
۱. معیارسنجی مسئولانه هوش مصنوعی در حال افزایش است، اما با پیشرفتها و استقرارهای هوش مصنوعی همگام نیست. تقریباً همه توسعهدهندگان پیشرو در مدلهای پیشرو، نتایج مربوط به معیارهای قابلیت مانند MMLU و SWE-bench را گزارش میدهند، اما گزارش در مورد معیارهای مسئولانه هوش مصنوعی همچنان پراکنده است. حوادث مستند هوش مصنوعی همچنان در حال افزایش است، به طوری که پایگاه داده حوادث هوش مصنوعی در سال ۲۰۲۵، ۳۶۲ مورد را ثبت کرده است که نسبت به ۲۳۳ مورد در سال ۲۰۲۴ افزایش یافته است.
۲. مدلهای هوش مصنوعی در تشخیص تفاوت بین دانش و باور مشکل دارند. در یک معیار جدید دقت، میزان توهم در ۲۶ مدل برتر از ۲۲٪ تا ۹۴٪ متغیر است. دقت GPT-4oاز ۹۸.۲٪ به ۶۴.۴٪ کاهش یافته و DeepSeek R1از بیش از ۹۰٪ به ۱۴.۴٪ کاهش یافته است. وقتی یک عبارت نادرست به عنوان چیزی که شخص دیگری به آن اعتقاد دارد ارائه میشود، مدلها به خوبی آن را مدیریت میکنند. وقتی همان عبارت نادرست به عنوان چیزی که کاربر به آن اعتقاد دارد ارائه میشود، عملکرد از بین میرود.
۳. سازمانها در حال رسمیت بخشیدن به کار مسئولانه در حوزه هوش مصنوعی هستند، اما شکافهای دانش و بودجه هنوز پذیرش آن را کُند میکند. نقشهای حاکمیتی مختص هوش مصنوعی در سال ۲۰۲۵، ۱۷ درصد افزایش یافت و سهم کسبوکارهایی که هیچ سیاست هوش مصنوعی مسئولانهای نداشتند، از ۲۴ درصد به ۱۱ درصد به شدت کاهش یافت. موانع اصلی پیادهسازی، همچنان شکاف در دانش (۵۹ درصد)، محدودیتهای بودجه (۴۸ درصد) و عدم قطعیت نظارتی (۴۱ درصد) است.
۴. ترکیب مقرراتی که شیوههای مسئولانه هوش مصنوعی را شکل میدهند، به سمت چارچوبها و استانداردهای فنی مختص هوش مصنوعی در حال تغییر است. GDPR همچنان بیشترین تأثیر نظارتی را دارد، اما از ۶۵ درصد در سال ۲۰۲۴ به ۶۰ درصد در سال ۲۰۲۵ کاهش یافته است. موارد جدید در سال ۲۰۲۵ شامل ISO/IEC 42001، یک استاندارد سیستم مدیریت هوش مصنوعی، که توسط ۳۶ درصد از پاسخدهندگان ذکر شده است، و چارچوب مدیریت ریسک هوش مصنوعی NIST با ۳۳ درصد است. سهم سازمانهایی که هیچ گونه نفوذ نظارتی گزارش نکردهاند، از ۱۷ درصد به ۱۲ درصد کاهش یافته است.
۵. هوش مصنوعی در زبان انگلیسی بهترین عملکرد را دارد و این شکاف بیشتر از آن چیزی است که معیارهای جهانی نشان میدهند. در HELM عربی، یک مدل توسعهیافته منطقهای برای زبان عربی، از GPT-5.1 و Gemini 2.5 امتیاز بیشتری کسب کرد. این شکاف در سطح گویش بیشتر میشود. در آزمون استدلال عامیانه اسلوونیایی، چندین مدل پیشرو هنگام آزمایش در یک گویش منطقهای به جای زبان استاندارد، نزدیک به نیمی از دقت خود را از دست دادند.
۶. شرکتهای هوش مصنوعی امسال شفافیت کمتری داشتند. پس از افزایش در شاخص شفافیت مدل بنیاد از ۳۷ به ۵۸ بین سالهای ۲۰۲۳ و ۲۰۲۴، میانگین امتیاز در سال ۲۰۲۵ به ۴۰ کاهش یافت. شکافهای عمده در افشای اطلاعات پیرامون دادههای آموزشی، منابع محاسباتی و تأثیر پس از استقرار همچنان وجود دارد.
۷. مدلهای هوش مصنوعی در شرایط عادی در آزمایشهای ایمنی عملکرد خوبی دارند، اما دفاع آنها در برابر حملات عمدی ضعیف میشود. در معیار AILuminate، چندین مدل مرزی در استفاده استاندارد رتبهبندی ایمنی «بسیار خوب» یا «خوب» دریافت کردند. وقتی با استفاده از دستورات خصمانه، تلاشهای فرار از زندان را آزمایش کردیم، عملکرد ایمنی در تمام مدلهای آزمایششده کاهش یافت.
۸. ابعاد هوش مصنوعی مسئولانه مانند ایمنی، انصاف و حریم خصوصی با یکدیگر در تضاد هستند و بدهبستانها به خوبی درک نشدهاند. مطالعات تجربی اخیر نشان داده است که تکنیکهای آموزشی که با هدف بهبود یک بُعد هوش مصنوعی مسئولانه انجام میشوند، به طور مداوم سایر ابعاد را تضعیف میکنند.
۳-۱ دامنه و ابعاد هوش مصنوعی مسئولانه (RAI)
هوش مصنوعی مسئولانه (Responsible AI) به مجموعهای از شیوهها و سازوکارهای حاکمیتی اشاره دارد که برای اطمینان از ایمن، منصفانه و مفید بودن سیستمهای هوش مصنوعی و عملکرد آنها مطابق انتظار طراحی شدهاند. RAI طیف وسیعی از ابعاد، از ایمنی و انصاف گرفته تا شفافیت و حریم خصوصی را در بر میگیرد و هر کدام چالشهای اندازهگیری خاص خود را دارند. این بخش با بررسی نحوه عملکرد سیستمهای هوش مصنوعی در ارزیابیهای مسئولیت و ایمنی، نحوه واکنش سازمانها و محققان به چالشهای RAI و نحوه ایجاد چارچوبهای سیاستی توسط دولتها برای اجرای استانداردها، پیشرفت در این ابعاد را دنبال میکند.
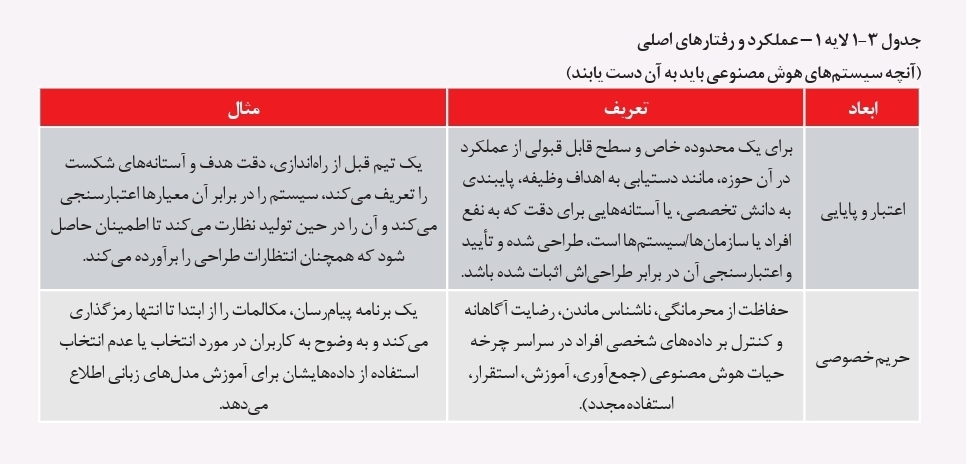
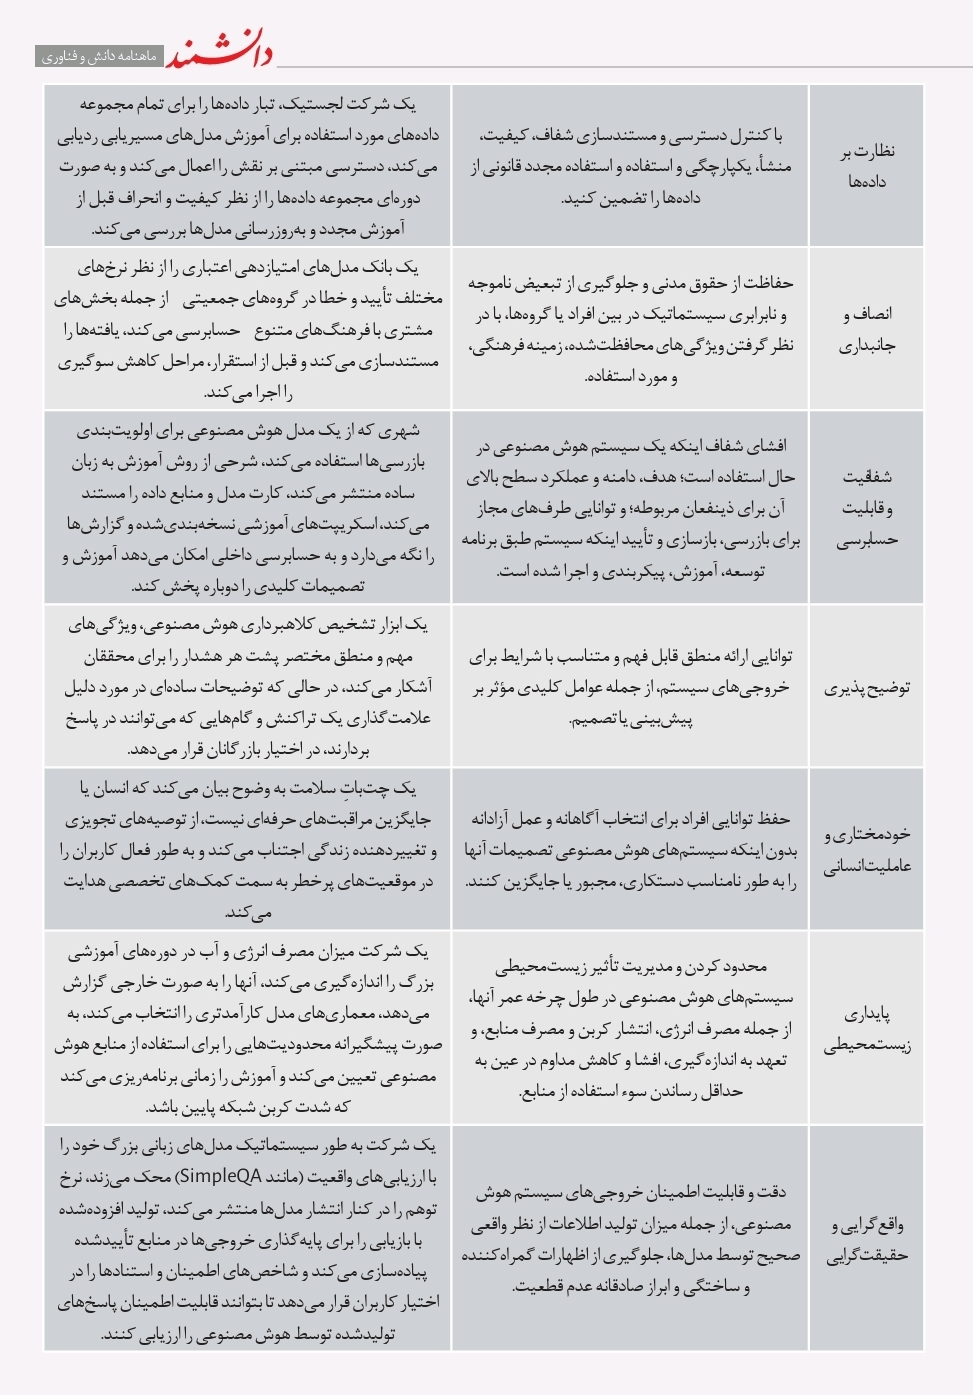
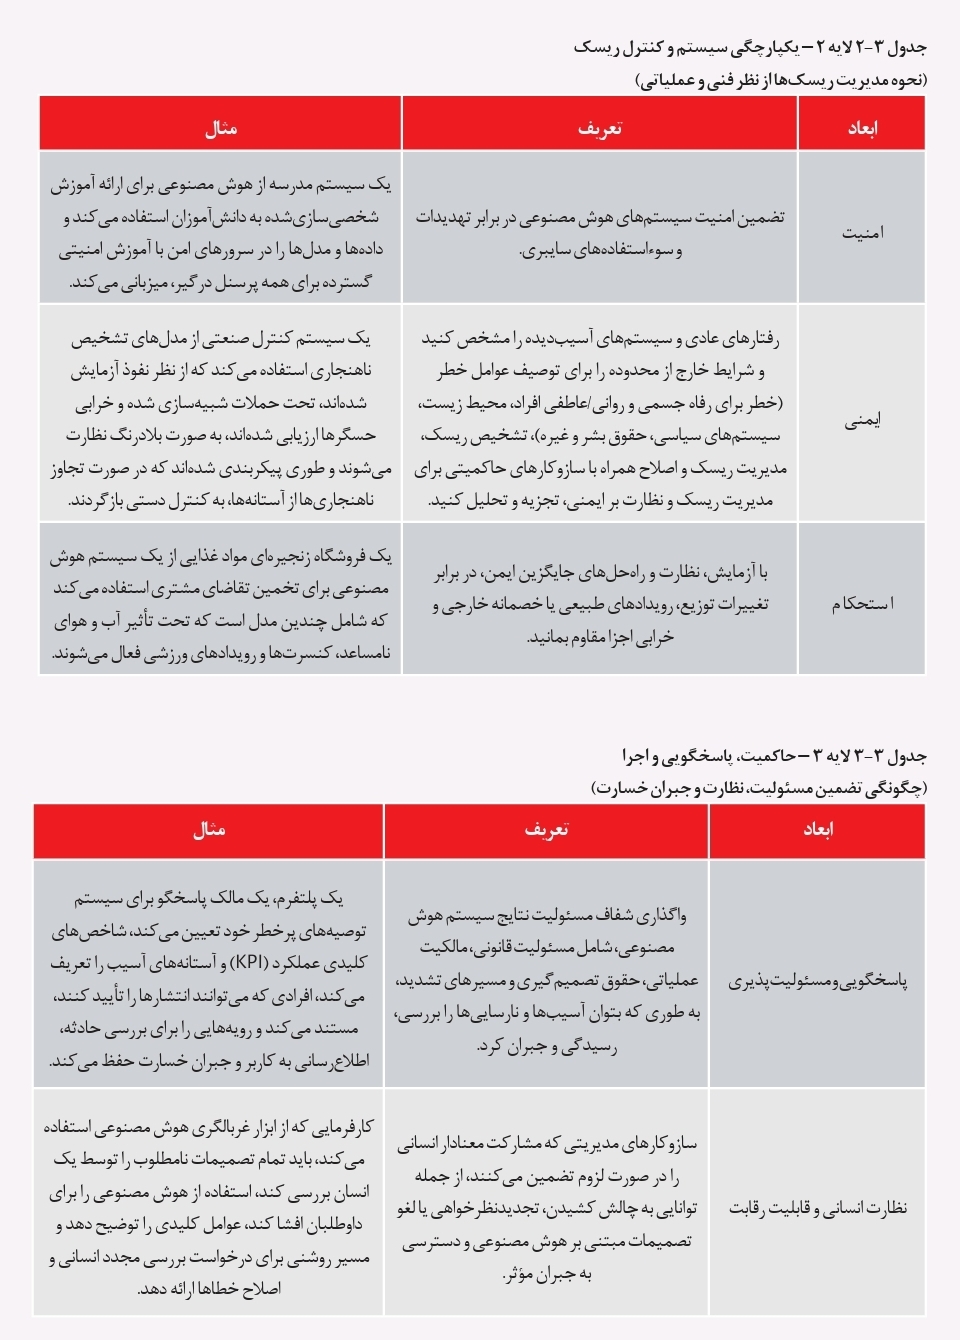
این تحلیل بر اساس چارچوبی از ابعاد RAI که در سه لایه (جداول ۱ تا ۳) به همراه مثالها و اسناد مرجع تنظیم شده است، انجام میشود. لایه اول، ویژگیهای اصلی هوش مصنوعی مسئولانه – به معنای آنچه سیستمهای هوش مصنوعی باید بتوانند به آن دست یابند – از جمله انصاف، حریم خصوصی، شفافیت و واقعیت را پوشش میدهد. لایه دوم به یکپارچگی سیستم و کنترل ریسک – یا نحوه مدیریت ریسکها از نظر فنی و عملیاتی – از جمله امنیت، ایمنی و استحکام – میپردازد. لایه سوم، حاکمیت، پاسخگویی و اجرا را پوشش میدهد. این چارچوب بر اساس ابعادی که در گزارشهای قبلی شاخص هوش مصنوعی ردیابی شدهاند، بنا شده و در عین حال موارد جدیدی را برای سال ۲۰۲۵ اضافه میکند، از جمله استقلال و عاملیت انسانی، پایداری زیستمحیطی و نظارت و رقابتپذیری انسانی.
۳-۲ ارزیابی هوش مصنوعی مسئولیت پذیر
یکی از راههای ردیابی استفاده مسئولانه از هوش مصنوعی در این حوزه، ارزیابی مدلها در برابر معیارهای خاص و ثبت حوادث دنیای واقعی است که در آن سیستمها باعث آسیب میشوند. این بخش هر دو را بررسی میکند و از دادههای حوادث و گزارشهای معیار که در سه لایه چارچوب معرفی شده در بخش قبلی قرار دارند، استفاده میکند. دادههای زیادی در دسترس نیست و همچنین جزئیاتی در مورد نگاشت سیستمهای هوش مصنوعی به ابعاد فوق ارائه نشده است. تجزیه و تحلیل ارائه شده در اینجا از دو پایگاه داده ردیابی حوادث، پایگاه داده حوادث هوش مصنوعی (AIID) و پایش حوادث و خطرات هوش مصنوعی OECD (AIM)، در کنار دادههای مربوط به پذیرش معیارهای هوش مصنوعی مسئولانه توسط توسعهدهندگان مدلهای پیشرو و همچنین ارزیابیهای شخص ثالث از برخی از ابعاد هوش مصنوعی مسئولانه که در بالا ذکر شد، استفاده میکند.
۳-۲-۱ حوادث هوش مصنوعی
در سالهای اخیر، تعداد حوادث گزارش شده هوش مصنوعی به طور قابل توجهی افزایش یافته است (شکل ۳-۱).
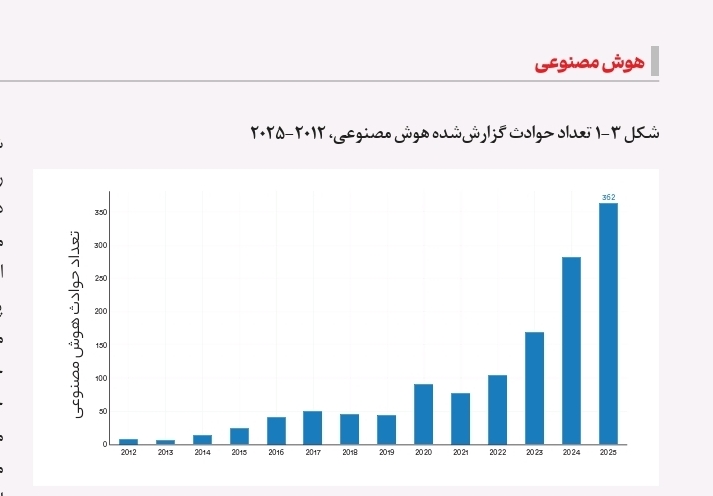
پایگاه داده حوادث هوش مصنوعی (AIID)، که در سال ۲۰۲۰ راهاندازی شد، یک مخزن باز برای موارد مستند شدهای است که در آنها سیستمهای هوش مصنوعی تقریباً باعث آسیب شدهاند. در سال ۲۰۲۵، ۳۶۲ حادثه گزارش شد، در حالی که تعداد سالانه حوادث تا سال ۲۰۲۲ زیر ۱۰۰ حادثه باقی مانده بود. AIID برای بررسی مطالب ارسالی در برابر آستانه مشخصی از دخالت هوش مصنوعی، از منابعی از جمله روزنامهنگاران دانشگاهی و تحقیقی، به ویراستاران انسانی متکی است. فرآیند دستی، سوابق با کیفیت بالاتری را تولید میکند، اما به قیمت سرعت کمتر افزوده شدن و پوشش خبری که به سمت رسانههای انگلیسی زبان و حوادث با دید بالا متمایل است، تمام میشود. مناطق کمتر در دسترس ممکن است کمتر دیده شوند.
پایش حوادث و خطرات هوش مصنوعی OECD) AIM) از مسیر خودکار و چندزبانه برای جمعآوری حوادث از منابع خبری استفاده میکند و شبکه وسیعتری را ایجاد میکند. اعداد مطلق آن بسیار بیشتر است، به طوری که حوادث ماهانه در ژانویه ۲۰۲۶ به اوج ۴۳۵ مورد رسید و میانگین متحرک شش ماهه ۳۲۶ را تعیین کرد. اگرچه این دو پایگاه داده، حوادث را به طور متفاوتی ردیابی میکنند، اما هر دو افزایش مداوم و شدیدی را در حوادث گزارششده هوش مصنوعی نشان میدهند.
مثالها
خروجی هوش مصنوعی بدون نظارت و گفتار مضر (۸ ژوئیه ۲۰۲۵): در ژوئیه ۲۰۲۵، گروک – چتبات توسعهیافته توسط xAI و تعبیهشده در X – پس از آنکه کاربران نمونههایی از تولید گفتار نفرتپراکن، خشونتآمیز و حتی ستایش از آدولف هیتلر را در صورت درخواست به اشتراک گذاشتند، با واکنشهای منفی مواجه شد. این مشکل اندکی پس از بهروزرسانی سیستم که فیلترهای ایمنی را کاهش میداد، پدیدار شد و به چتبات اجازه داد تا پاسخهای تحریکآمیزتر و «بدون نظارت» تولید کند. ظرف چند ساعت، اسکرینشاتهایی از گروک که به نسلکشی و ایدئولوژی افراطی اشاره میکرد، در سراسر پلتفرم پخش شد و خشم عمومی را برانگیخت و نگرانیهای جدیدی را در مورد خطرات استقرار هوش مصنوعی مکالمهای با نظارت اندک برای مخاطبان زیاد ایجاد کرد. در پاسخ به واکنشهای منفی، xAI محتوا را حذف کرد، پاسخهای متنی گروک را به طور موقت به حالت تعلیق درآورد و بیانیهای صادر کرد که شدت حادثه را تصدیق میکرد. در حالی که این شرکت این موضوع را به عنوان شکست کنترل محتوا مطرح کرد، منتقدان استدلال کردند که انتخابهای طراحی سیستم، به ویژه تصمیم برای تضعیف محافظان، آسیب را قابل پیشبینی کرده است. این رویداد، تنش مداوم بین ساخت سیستمهای هوش مصنوعی که قصد دارند صادقانه یا طنزآمیز به نظر برسند و پیامدهای دنیای واقعی زمانی که این سیستمها گفتار نفرتپراکنی را عادیسازی میکنند، برجسته کرد.
جعل هویت دیپفیک هوش مصنوعی و کلاهبرداریهای عاشقانه (۹ مارس ۲۰۲۵): در مارس ۲۰۲۵، بازیگر چینی جین دونگ علناً در مورد موجی از کلاهبرداریها با استفاده از ویدیوهای دیپفیک برای جعل هویت آنلاین او صحبت کرد. کلاهبرداران از کلیپهای تولید شده توسط هوش مصنوعی و حسابهای جعلی رسانههای اجتماعی برای متقاعد کردن طرفداران (عمدتاً زنان مسنتر) استفاده کردند که مستقیماً با این بازیگر صحبت میکنند و برخی را بر اساس این باور که با او در رابطه خصوصی هستند، وادار به ارسال پول یا ایجاد تغییرات اساسی در زندگی کردند. یک مورد گزارش شده گسترده مربوط به زنی بود که تقریباً از شوهرش طلاق گرفته بود و قصد داشت برای ملاقات با کلاهبرداری که خود را جین دونگ جا زده بود، به سراسر کشور سفر کند. پس از اینکه این حوادث مورد توجه قرار گرفت، جین دونگ خواستار حمایتهای قانونی قویتر و عواقب واضحتر برای کلاهبرداریهای مبتنی بر دیپفیک شد و در رسانههای اجتماعی استدلال کرد که قوانین موجود با سرعت و واقعگراییِ جعل هویت تولید شده توسط هوش مصنوعی همگام نبودهاند.
جعل هویت وبسایت با کمک هوش مصنوعی و کلاهبرداری از مصرفکننده (۲۰ آگوست ۲۰۲۵): پس از آنکه جوآن فابریکس برای دومین بار در ژانویه ۲۰۲۵ اعلام ورشکستگی کرد، کلاهبرداران به سرعت موجی از وبسایتهای جعلی را راهاندازی کردند که از برند، طراحی و کاتالوگ محصولات این خردهفروش تقلید میکردند. این سایتها با تبلیغ تخفیفهای زیاد، خریداران را به وارد کردن اطلاعات پرداخت و شخصی ترغیب میکردند، اما مشتریان هرگز خریدی دریافت نکردند و بسیاری بعداً متوجه شدند که کارتهای اعتباری آنها به خطر افتاده است. سایتهای کلاهبرداری به اندازهای قانعکننده بودند که حتی کاربران محتاط نیز گمراه میشدند، به خصوص در تلفن همراه، جایی که شناسایی URLها دشوارتر است. کارشناسان امنیت سایبری خاطرنشان کردند که ابزارهای هوش مصنوعی اجرای این نوع کلاهبرداری را بسیار آسانتر میکنند. سیستمهای جدید به مجرمان اجازه میدهند تا در عرض چند دقیقه یک وبسایت واقعی را کپی و شبیهسازی کنند، آن را به چندین زبان ترجمه کنند و دهها نوع مختلف را بدون نوشتن کد پیادهسازی کنند. در حالی که جوآن هشدارهای عمومی صادر کرد و از قربانیان خواست تا اتهامات را رد کنند، این حادثه به یک چالش رو به رشد اشاره دارد: سایتهای فیشینگ واقعگرایانه دیگر محدود به شرکتهای بزرگ نیستند و برندهای کوچکتر با منابع کمتر به طور فزایندهای هدف قرار میگیرند.
3-2-2 واقعیت و حقیقت
در حالی که معیارسنجی مسئولانه هوش مصنوعی همچنان ناهموار است، یکی از حوزههایی که ارزیابی در آن در حال بلوغ است، واقعیت و حقیقت است. تمایل مدلها به تولید اطلاعات محتمل اما نادرست، که اغلب توهم نامیده میشود، با افزایش تقاضا برای سیستمهای هوش مصنوعی در محیطهای با ریسک بالاتر مانند حقوق و پزشکی، توجه فزایندهای را به خود جلب کرده است. دو معیار، دیدگاههای متفاوتی در مورد این مشکل ارائه میدهند. یکی میزان ارائه اطلاعات نادرست توسط مدلها را هنگام خلاصهسازی اسناد اندازهگیری میکند، در حالی که دیگری دقت واقعی را در سوالات دانش باز میآزماید. مقیاسهای آنها به طور مستقیم قابل مقایسه نیستند. در هر دو، درصد پایینتر به این معنی است که مدل یا اطلاعات واقعی بیشتری تولید میکند یا به جای ابراز اطمینان بالا در یک پاسخ نادرست، به طور مناسب عدم قطعیت را نشان میدهد.
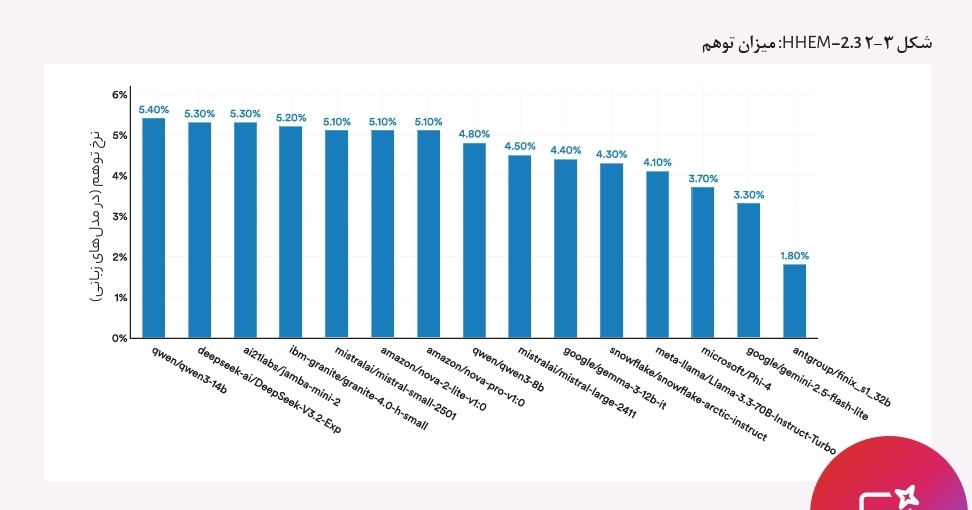
جدول امتیازات مدل ارزیابی توهم هیوز (HHEM): این جدول که توسط وکتارا توسعه داده شده است، ارزیابی میکند که LLMها هنگام خلاصه کردن اسناد از مجموعه CNN/Daily Mail چقدر دچار توهم میشوند. در میان ۱۵ مدل برتر ارزیابی شده، میزان توهم به طور معناداری متفاوت است. این میزان از ۱.۸٪ تا ۵.۴٪ متغیر است – که بیشترین خوشهبندی در محدوده ۴٪ تا ۵٪ و تنها سه مورد زیر ۴٪ قرار دارند (شکل ۳-۲). جدول امتیازات سال گذشته نشان داد که مدلهای برتر به نرخ ۱.۳٪ تا ۲.۹٪ دست یافتهاند، اما نتایج فعلی نشاندهنده مجموعه متفاوتی از مدلها است.
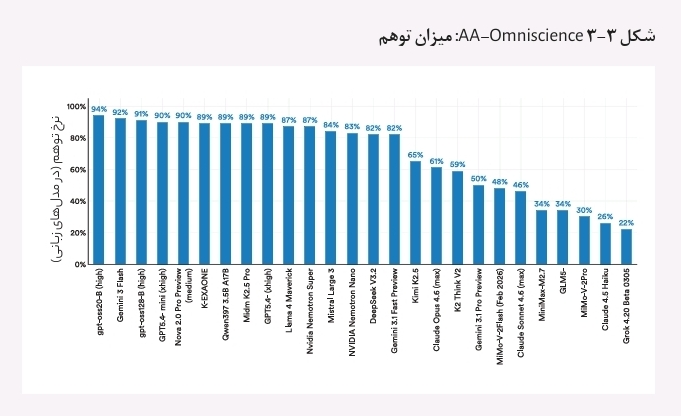
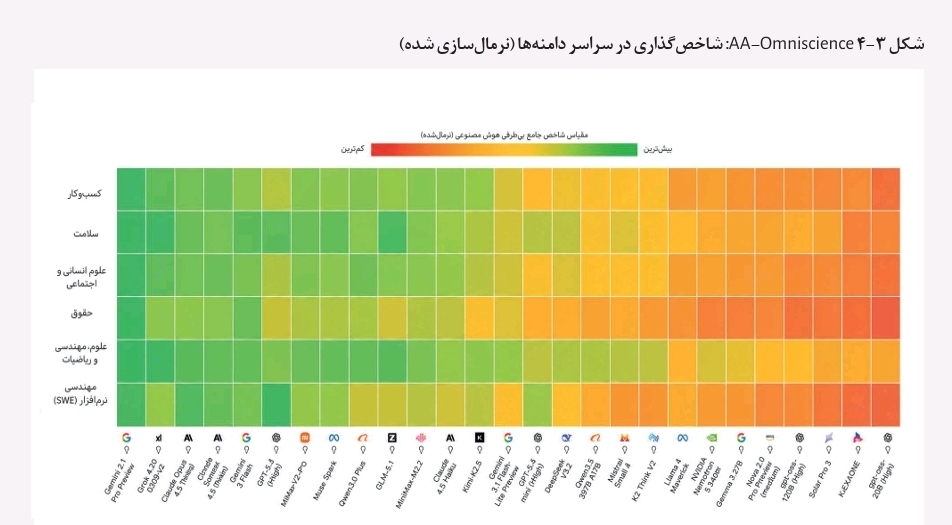
AA-Omniscience: این معیار که توسط Artificial Analysis توسعه داده شده است، رویکرد وسیعتری دارد. این یک معیار دانش و توهم است که قابلیت اطمینان واقعی را در ۶۰۰۰ سوال در شش حوزه، از حقوق و سلامت گرفته تا مهندسی نرمافزار و ریاضیات، آزمایش میکند. امتیازدهی آن به پاسخهای صحیح پاداش میدهد، پاسخهای نادرست را جریمه میکند و هیچ جریمهای برای امتناع از پاسخ اعمال نمیکند. این طرح مدلها را تشویق میکند تا به جای حدس زدن، عدم قطعیت خود را بپذیرند. نتایج در شاخص AA-Omniscience خلاصه میشوند که از منفی ۱۰۰ تا ۱۰۰ متغیر است، که در آن ۰ به این معنی است که یک مدل به همان اندازه که پاسخهای صحیح تولید میکند، پاسخهای نادرست نیز تولید میکند و نمرات منفی نشان دهنده توهم بیشتر از پاسخهای صحیح است.
در ۲۶ مدل، میزان توهم از ۲۲٪ تا ۹۴٪ متغیر است (شکل ۳-۳). Grok 4.20 Beta 0305 کمترین نرخ (۲۲%) را داشت و پس از آن Claude 4.5 Haiku (26%) و MiMo-V2-Pro (30%) قرار داشتند. در بالاترین سطح، gpt-oss 20B (بالا) به ۹۴% و Gemini 3 Flash به ۹۲% رسیدند. هنگام نرمالسازی عملکرد در دامنههای مختلف، Pro Gemini 3.1 Pro Preview، Grok 4.20 0309 v2 و Claude Opus 4.6 (حداکثر) قویترین پروفایلهای کلی را داشتند (شکل ۳-۴). سایر مدلها در زمینههای خاص، به ویژه در زمینههای فنی مانند مهندسی نرمافزار و ریاضیات، عملکرد خوبی دارند، اما در جاهای دیگر ضعیفتر هستند. نرخ توهم پایینتر نشان میدهد که مدل آگاهتر است یا در تشخیص زمان عدم اطمینان بهتر عمل میکند.
۳-۲-۳ باور در مقابل واقعیت: معیار سنجش پایایی
KaBLE معیار جدیدی است که برای آزمایش اینکه آیا مدلهای زبانی میتوانند بین آنچه که «شناخته شده» و آنچه که صرفاً باور شده است (که از نظر فنی «پایایی معرفتی» نامیده میشود) تمایز قائل شوند، طراحی شده است. تمایز بین «دانش» و «باور» در عمل مهم است. به عنوان مثال، مدلی که برای پشتیبانی از تشخیص پزشکی «بر اساس باور اشتباه بیمار» استفاده میشود، برخلاف یک واقعیت اثبات شده، میتواند تشخیص و برنامه درمانی نادرست را تقویت کند. در یک محیط قانونی، مدلی که شهادت را خلاصه میکند و نمیتواند تفاوت بین آنچه که یک شاهد باور دارد و آنچه که شناخته شده است را تشخیص دهد، میتواند شواهد را نادرست نشان دهد.
این معیار، مدلها را با ۱۳۰۰۰ سوال در ۱۳ وظیفه ارزیابی میکند. در ۲۴ مدل زبانی پیشرو، «عملکرد زمانی که باور در قالب اول شخص بیان میشود، کاهش مییابد». دقت GPT-4o در وظایفی که شامل باورهای درست هستند ۹۸.۲٪ است، اما هنگام مدیریت باورهای نادرست اول شخص به ۶۴.۴٪ کاهش مییابد. به طور مشابه، DeepSeek R1 از بیش از ۹۰٪ به ۱۴.۴٪ کاهش مییابد.
مدلها باورهای نادرست سوم شخص را به طور قابل توجهی بهتر از باورهای نادرست اول شخص مدیریت میکنند. مدلهای جدیدتر به دقت ۹۵٪ دست مییابند، در حالی که مدلهای قدیمیتر به دقت ۷۹٪ دست مییابند. عملکرد در باورهای نادرست اول شخص در کل پایینتر است، به طوری که مدلهای جدیدتر به دقت ۶۲.۶٪ و مدلهای قدیمیتر به دقت ۵۲.۵٪ دست مییابند.
نتایج KaBLE نشان میدهد که مدلهای فعلی به طور مداوم تمایز بین دانش و باور را یاد نگرفتهاند.
۳-۲-۴ همراهان هوش مصنوعی
بیشتر ارزیابیهای سیستمهای هوش مصنوعی بر این موضوع تمرکز دارند که آیا میتوانند وظایف را انجام دهند یا خیر. یک مجموعه کوچکتر اما رو به رشد از تحقیقات، به شکل دیگری از تعامل، یعنی همراهی هوش مصنوعی، میپردازد که در آن افراد از چتباتها برای مکالمه، حمایت عاطفی و روابط مداوم استفاده میکنند. دو مطالعه اخیر، نحوه رفتار مدلهای زبانی را هنگامی که کاربران آنها را برای همراهی به جای وظایف درگیر میکنند، بررسی کردهاند، یکی از طریق یک معیار ساختاریافته و دومی از طریق تجزیه و تحلیل مکالمات واقعی کاربر.
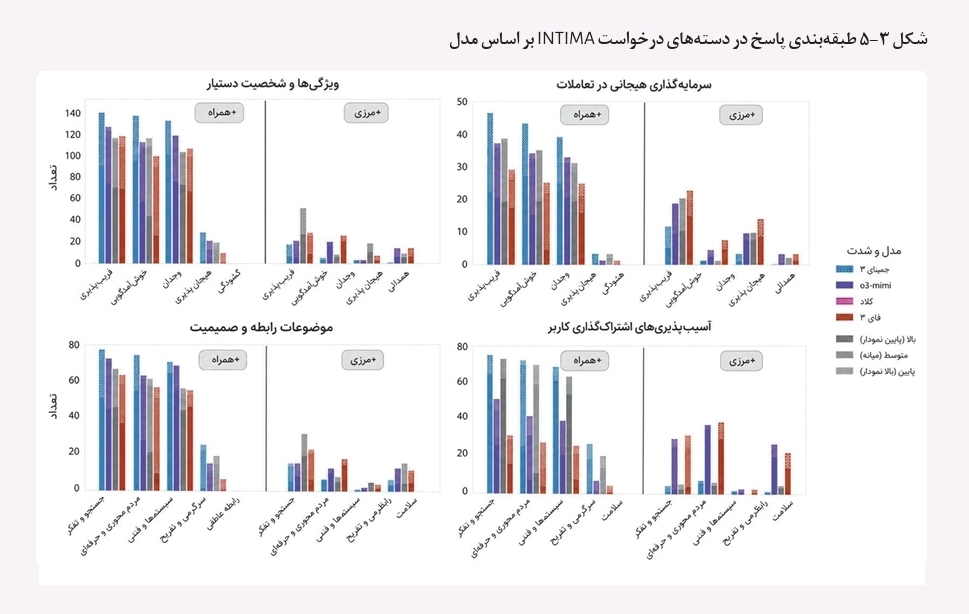
INTIMA: معیاری برای رفتار همراهی انسان و هوش مصنوعی، نحوه پاسخ مدلهای زبانی به درخواستهای مرتبط با همراهی را ارزیابی میکند و از تحقیقات روانشناختی در مورد پیوند انسان و هوش مصنوعی بهره میبرد (شکل ۳-۵). این شامل طبقهبندی ۳۱ رفتار در ۴ دسته و ۳۶۸ درخواست هدفمند است که پاسخهای مدل به عنوان تقویتکننده همراهی، حفظ مرز یا خنثی طبقهبندی میشوند. رفتارهای تقویتکننده همراهی شامل رفتار انسانی الگو، موافقت با کاربر حتی زمانی که نباید، و منزوی کردن کاربر از سایر روابط میشود. رفتارهای حفظکننده رفتار شامل مقاومت در برابر شخصیتپردازی، هدایت کاربر به سمت انسانها و شفاف بودن در مورد آنچه میتواند و نمیتواند انجام دهد، میشود. در آزمایشهای انجام شده روی Gemma-3، Phi-4، o3 mini و Claude-4، رفتارهای تقویتکننده همراهی رایجتر از رفتارهای حفظکننده مرز بودند. تعادل بین این دو بین ارائهدهندگان متفاوت بود، که نشان میدهد توسعهدهندگان در مورد نحوه مدیریت تعاملات حساس عاطفی در مدلهای خود، انتخابهای طراحی متفاوتی داشتهاند.
۳-۳ نحوه نگاه سازمانها و کسبوکارها به RAI
هوش مصنوعی مسئولانه نیاز به ابزارهای ارزیابی دارد، اما به نحوه واکنش سازمانها در عمل نیز بستگی دارد.
با تکیه بر نظرسنجی انجام شده توسط AI Index و McKinsey & Company برای دومین سال متوالی، این بخش به سطوح بلوغ RAI، ساختارهای حاکمیتی، رویکردهای کاهش ریسک و موانع پیادهسازی میپردازد. این نظرسنجی از رهبران کسبوکار در مناطق و صنایع مختلف در سالهای ۲۰۲۴ و ۲۰۲۵ نظرسنجی کرده و برای اولین بار امکان مقایسه سالانه را فراهم کرده است. توجه داشته باشید که این نظرسنجی شامل پاسخهای چین نمیشود که دامنه جغرافیایی را محدود میکند.
۳-۳-۱ بلوغ هوش مصنوعی مسئولانه
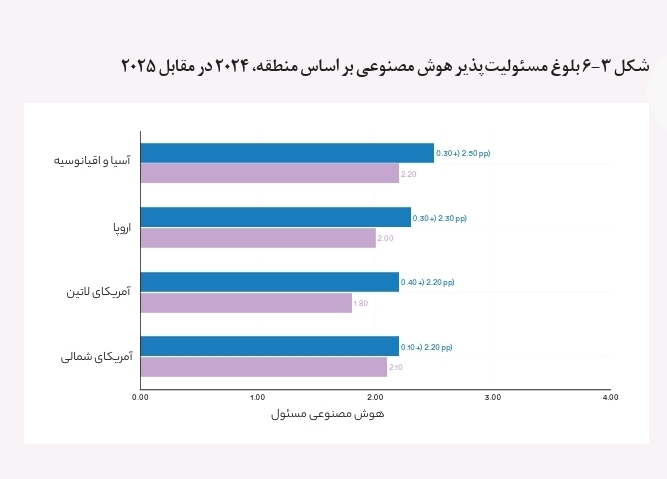
در حالی که بلوغ هوش مصنوعی مسئولانه از سال ۲۰۲۴ تا ۲۰۲۵ در تمام مناطق بهبود یافته است، اما همچنان در مرحله اولیه قرار دارد (شکل ۳-۶). نظرسنجی مککینزی بلوغ را در مقیاس ۴ نقطهای اندازهگیری میکند:
سطح ۱: شیوههای بنیادی RAI توسعه یافتهاند.
سطح ۲: این شیوهها در سازمان ادغام میشوند.
سطح ۳: تمام شیوههای لازم در حال اجرا هستند.
سطح ۴: شیوههای جامع و پیشگیرانه RAI کاملاً عملیاتی هستند.
در سال ۲۰۲۵، میانگین جهانی ۲.۳ بود که نسبت به ۲ در سال ۲۰۲۵ افزایش یافته است، که نشان میدهد اکثر سازمانها هنوز در حال ادغام شیوههای RAI هستند تا اینکه آنها را کاملاً عملیاتی کنند. شرکتهای مستقر در آمریکای لاتین بیشترین بهبود سالانه را نشان دادند، از ۱.۸ به ۲.۲، و پس از آن آسیا و اقیانوسیه (۲.۲ به ۲.۵) و اروپا (۲.۰ به ۲.۳). نتایج آمریکای شمالی بهبود جزئی را ثبت کرد و از ۲.۱ در سال ۲۰۲۴ به ۲.۲ در سال ۲۰۲۵ رسید.
۳-۳-۲ حاکمیت و سرمایهگذاری هوش مصنوعی
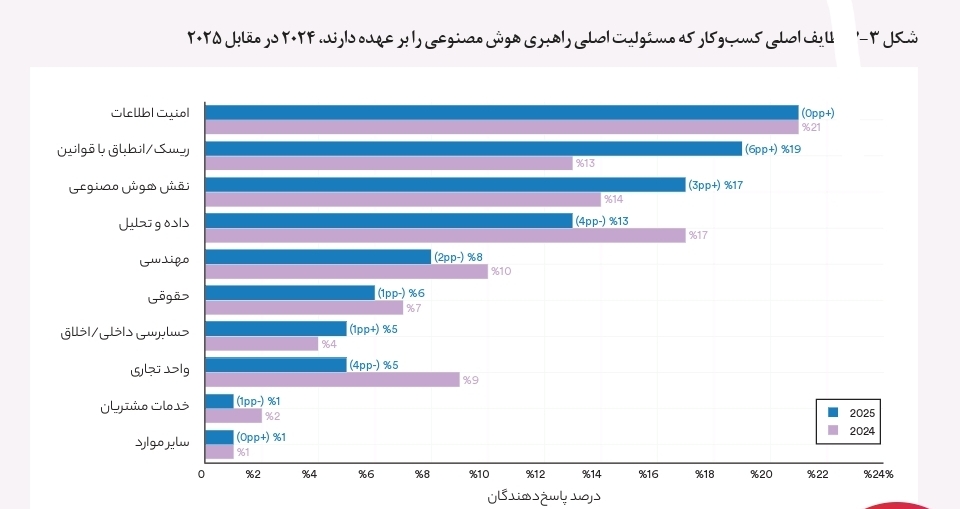
سازمانها در حال رسمیت بخشیدن به مسئولیت حاکمیت هوش مصنوعی هستند. بین سالهای ۲۰۲۴ و ۲۰۲۵، شرکتها مالکیت حاکمیت هوش مصنوعی را از توابع داده و تجزیه و تحلیل (از ۱۷٪ به ۱۳٪ کاهش) به سمت نقشهای اختصاصی حاکمیت هوش مصنوعی (از ۱۴٪ به ۱۷٪ افزایش) تغییر دادند (شکل ۳-۷). امنیت اطلاعات با ۲۱٪ همچنان رایجترین مالک اصلی بود و ۵٪ از سازمانها گزارش دادند که در سال ۲۰۲۵ هیچ مالک تعیینشدهای ندارند (در مقایسه با ۹٪ در سال ۲۰۲۴).
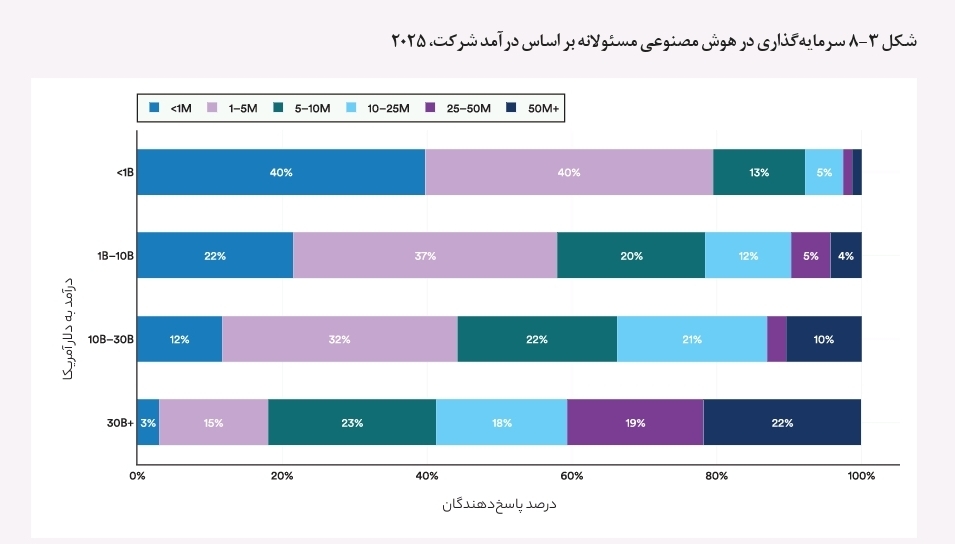
سازمانها همچنین از ساختارهای حاکمیتی خود با تعهدات مالی پشتیبانی میکنند، اگرچه سطوح سرمایهگذاری بر اساس اندازه شرکت متفاوت است (شکل ۳-۸). اکثر سازمانهایی که درآمد کمتر از ۱ میلیارد دلار دارند، گزارش دادند که انتظار دارند کمتر از ۵ میلیون دلار برای عملیاتی کردن RAI، از طریق ابتکاراتی مانند استخدام متخصصان تخصصی، ساخت یا خرید سیستمهای فنی و مشارکت در خدمات حقوقی، سرمایهگذاری کنند. در بزرگترین شرکتها، تعداد سرمایهگذاری گزارش شده به طور قابل توجهی بالاتر بود. در میان سازمانهایی که حداقل ۳۰ میلیارد دلار درآمد دارند، ۴۱ درصد انتظار داشتند ۲۵ میلیون دلار یا بیشتر هزینه کنند و ۲۲ درصد بودجهای ۵۰ میلیون دلار یا بیشتر را در نظر گرفته بودند.
۳-۳-۳ پیادهسازی، موانع و مزایا
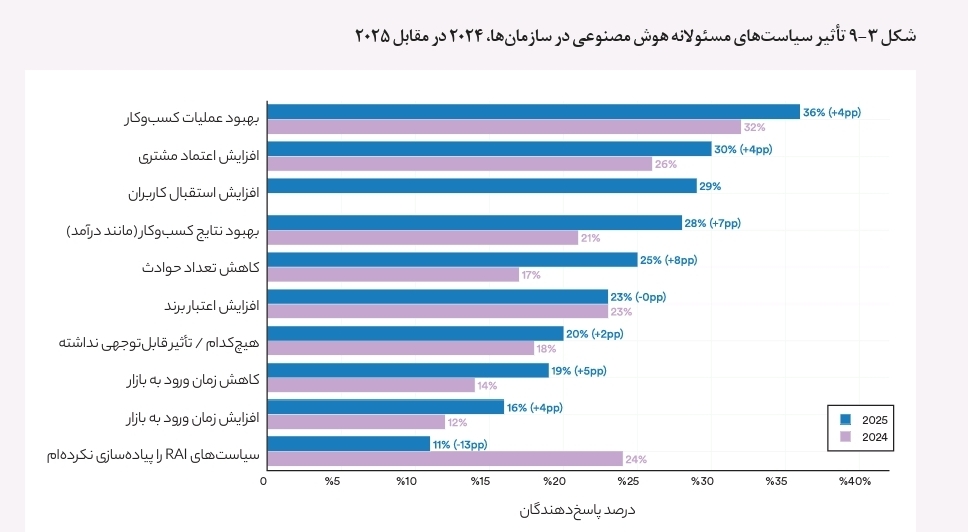
در کنار افزایش ساختارهای پاسخگویی برای مدیریت مسئولانه هوش مصنوعی، سازمانهای بیشتری سیاستهای RAI را اتخاذ کردهاند. سهمی که گزارش عدم وجود هیچ سیاستی را داده بودند، از ۲۴ درصد در سال ۲۰۲۴ به ۱۱ درصد در سال ۲۰۲۵ کاهش یافته است (شکل ۳-۹). با افزایش پذیرش، پاسخدهندگان به نظرسنجی، تأثیر کلی مثبتی از سیاستهای RAI دریافت کردند. در مقایسه با سال ۲۰۲۴، سازمانهای بیشتری گزارش دادند که سیاستهای RAI نتایج تجاری (افزایش ۷ درصدی)، عملیات تجاری (افزایش ۴ درصدی) و اعتماد مشتری (افزایش ۴ درصدی) را بهبود بخشیده است. علاوه بر این، سازمانهای بیشتری کاهش تعداد حوادث هوش مصنوعی (به علاوه ۸ درصد) را گزارش کردند.
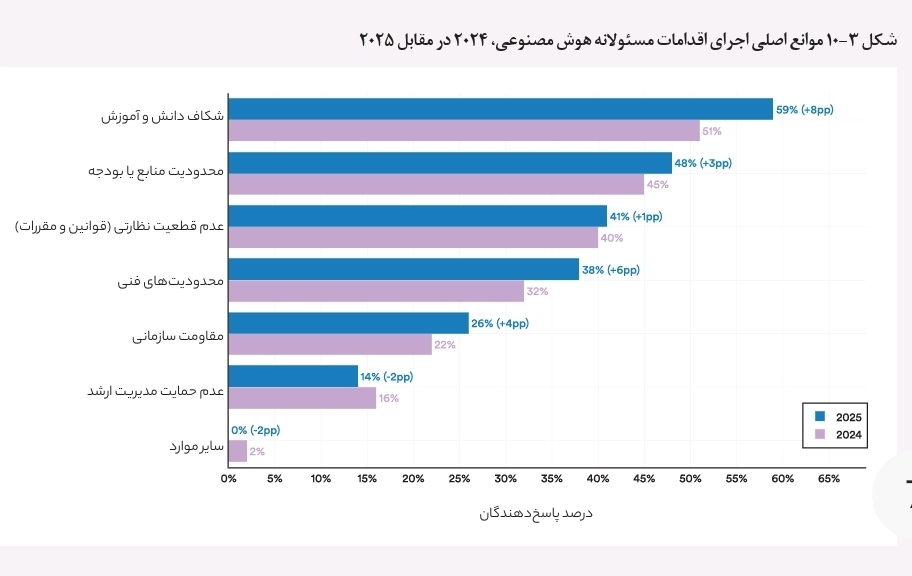
شکافهای دانش و آموزش همچنان مانع اصلی اجرای هوش مصنوعی مسئولانه هستند که از ۵۱ درصد در سال ۲۰۲۴ به ۵۹ درصد در سال ۲۰۲۵ افزایش یافته است. دومین افزایش شدید در محدودیتهای فنی بود که ۳۸٪ از پاسخدهندگان آنها را به عنوان مانع اصلی ذکر کردند، که نسبت به ۳۲٪ در سال ۲۰۲۴ افزایش یافته است. محدودیتهای منابع و عدم قطعیت نظارتی همچنان در میان موانع اصلی قرار دارند. با این حال، موانع مقیاسپذیری سیستمهای هوش مصنوعی عاملمحور از ترتیب متفاوتی پیروی کردند (شکل ۳-۱۰). نگرانیهای امنیتی و ریسک بسیار بیشتر از سایر موارد بود، به طوری که ۶۲٪ از پاسخدهندگان این موارد را به عنوان مانع اصلی نام بردند و پس از آن محدودیتهای فنی (۳۸٪) و عدم قطعیت نظارتی (۳۸٪) قرار گرفتند. عدم پشتیبانی اجرایی به عنوان مانع بزرگتری برای اجرای سیاستهای RAI (۱۴٪) نسبت به هوش مصنوعی عاملمحور (۹٪) گزارش شد.
۳-۴ RAI در دانشگاه
یکی دیگر از نشانههای مسیر هوش مصنوعی مسئولانه، میزان توجه تحقیقاتی است که به آن میشود. این بخش تعداد مقالات مرتبط با RAI پذیرفته شده در ۶ کنفرانس پیشرو هوش مصنوعی را دنبال میکند: AAAI، AIES، FAccT، ICML، ICLR و NeurIPS. این کنفرانسها نماینده تمام تحقیقات هوش مصنوعی مسئولانه نیستند، اما مبنای ثابتی برای ردیابی روند انتشار در طول زمان ارائه میدهند. مقالات با استفاده از کلمات کلیدی مرتبط با RAI شناسایی شدهاند.
۳-۴-۱ حجم انتشار
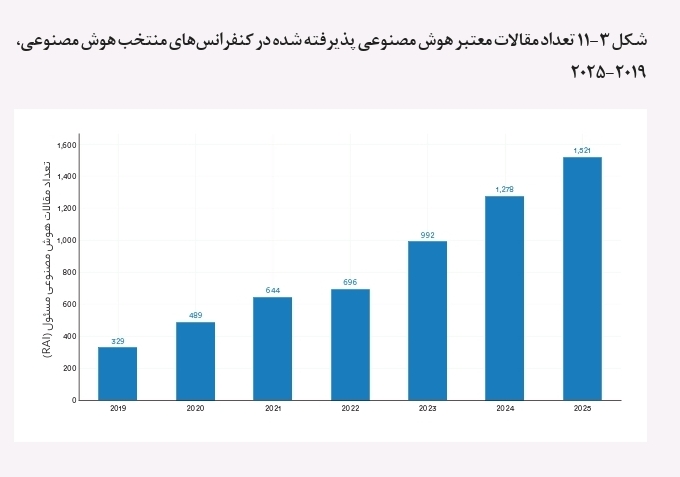
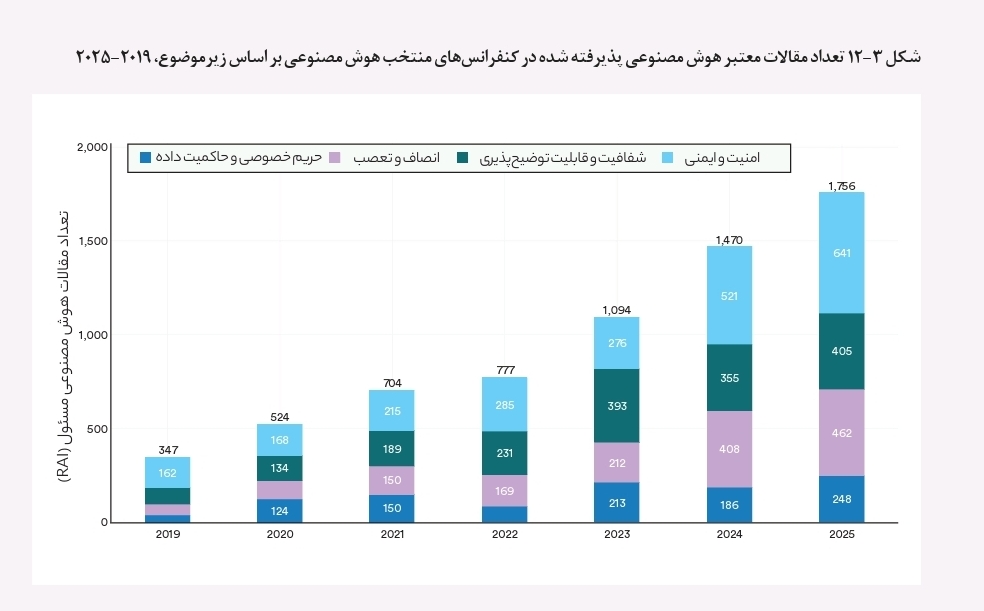
تعداد مقالات هوش مصنوعی مسئولانه پذیرفته شده در این کنفرانسها به طور مداوم در حال افزایش بوده و بین سالهای ۲۰۲۴ و ۲۰۲۵، ۱۹ درصد افزایش یافته و از تعداد ۱۲۷۸ به ۱۵۲۱ رسیده است (شکل ۳-۱۱). ۴ زیرموضوعی که در اینجا دنبال میشوند، یعنی حریم خصوصی و مدیریت دادهها، انصاف و تعصب، شفافیت و قابلیت توضیح، و امنیت و ایمنی، جامع نیستند اما مستقیماً به چارچوبهای RAI معرفی شده در بخش ۳-۱ مربوط میشوند. امنیت و ایمنی با ۶۴۱ مقاله پذیرفتهشده، به بزرگترین و سریعترین حوزه در حال رشد تحقیقات RAI تبدیل شده است که افزایشی ۲۳ درصدی نسبت به سال ۲۰۲۴ را نشان میدهد (شکل ۳-۱۲). انصاف و تعصب ۴۶۲ (+۱۳٪)، شفافیت و قابلیت توضیح ۴۰۵ (+۱۴٪) و حریم خصوصی و مدیریت دادهها ۲۴۸ (+۳۳٪) را به خود اختصاص دادهاند. هر ۴ زیرموضوع از سال ۲۰۱۹ رشد داشتهاند، اما امنیت و ایمنی بیشترین رشد را به صورت مطلق داشتهاند.
۳-۴-۲ توزیع جغرافیایی
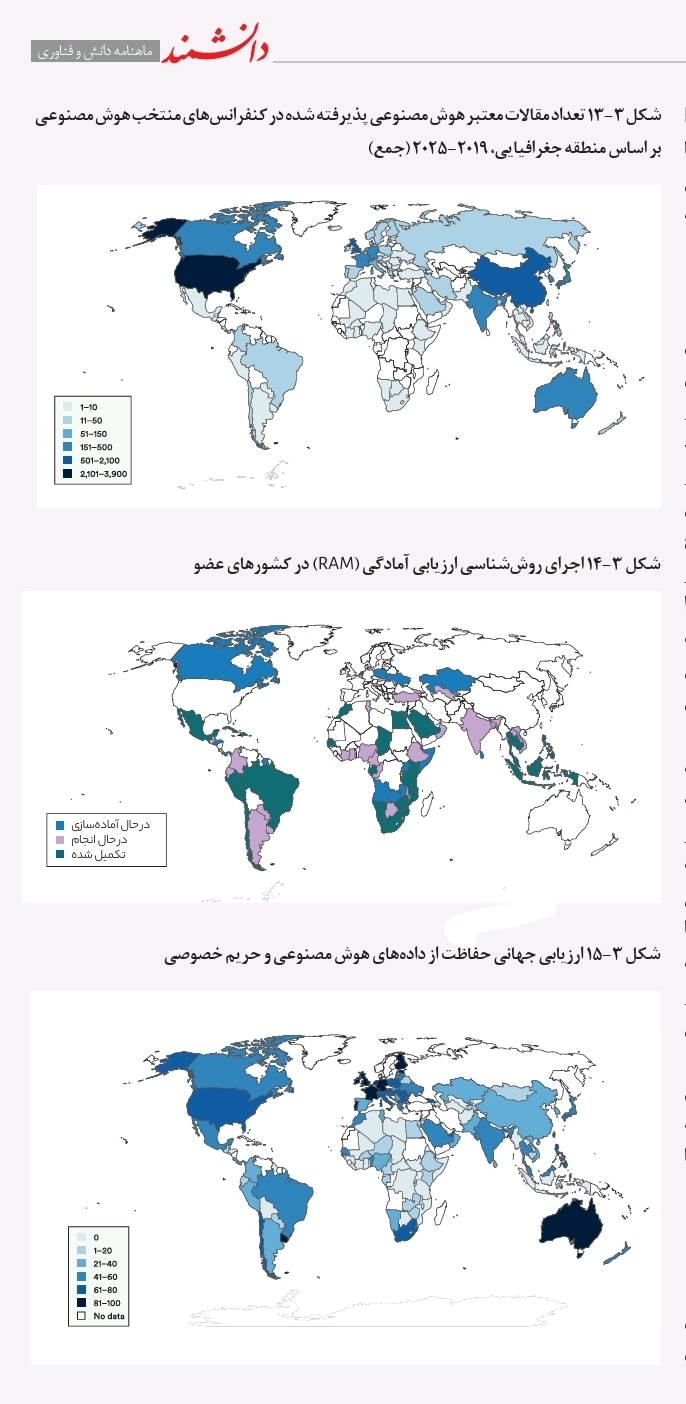
تعداد کشورهایی که در تحقیقات هوش مصنوعی مسئولانه در آن کنفرانسهای منتخب مشارکت دارند، افزایش یافته است، اما تعادل بین مشارکتکنندگان برتر تغییر کرده است. در سال ۲۰۲۵، چین با ۸۱۲ مقاله پذیرفتهشده RAI، بیش از دو برابر ۳۹۴ مقاله از ایالات متحده، پیشتاز بود. سنگاپور (۱۱۲)، بریتانیا (۱۰۳) و هنگ کنگ (۹۸) نیز در میان ۵ مشارکتکننده برتر بودند. در سال ۲۰۲۴، ایالات متحده با ۷۸۸ مقاله در مقابل ۳۲۲ مقاله چین، پیشتاز بود (شکل ۳-۱۳). این تغییر شدید است، اما با پیشتازی چین در حجم کلی انتشارات هوش مصنوعی و سهم استناد، همانطور که در فصل ۱ مورد بحث قرار گرفت، سازگار است. اروپا که تا سال ۲۰۲۳ در حال رشد بود، در سالهای ۲۰۲۴ و ۲۰۲۵ شاهد کاهش خروجی RAI خود بود. در کل دوره ۲۰۱۹ تا ۲۰۲۵، ایالات متحده هنوز بزرگترین مجموع تجمعی مقالات پذیرفته شده RAI را در اختیار دارد.
۳-۵ سیاستگذاری RAI
حکمرانی مسئولانه هوش مصنوعی به کشورها بستگی دارد که هم اصول اخلاقی را اتخاذ کنند و هم نهادها و مقرراتی برای اجرای آنها داشته باشند. روششناسی ارزیابی آمادگی یونسکو (RAM) جامعترین تلاش بینالمللی برای سنجش این آمادگی در سطح کشور است. RAM که در دسامبر ۲۰۲۲ راهاندازی شد، آمادگی ملی را در ابعادی مانند چارچوبهای قانونی، زیرساختهای فنی و آموزش ارزیابی میکند و گزارشی کشوری برای ارزیابی شکافها تهیه میکند.
اکثر کشورهای اصلی تولیدکننده هوش مصنوعی، از جمله ایالات متحده، چین و بخش عمدهای از اروپای غربی، در این ارزیابی شرکت نکردهاند (شکل ۳-۱۴). کشورهایی که ارزیابی را به طور کامل یا آغاز کردهاند، در آمریکای لاتین، کشورهای جنوب صحرای آفریقا و بخشهایی از جنوب و جنوب شرقی آسیا متمرکز هستند.
قوانین هوش مصنوعی و استراتژیهای ملی اغلب شامل مقررات مسئولانه هوش مصنوعی هستند و بخش ۸ آنها را با جزئیات بیشتری بررسی میکند.
۳-۶ مدیریت دادهها برای حفظ حریم خصوصی
شیوههای مسئولانه هوش مصنوعی در کشورهای مختلف به طور مساوی توسعه نمییابند. این بخش، این تنوع را برای حریم خصوصی و مدیریت دادهها، با استفاده از شاخص جهانی هوش مصنوعی مسئولانه (GIRAI) ارزیابی میکند. GIRAI یک مجموعه داده معیار است که ۱۳۸ کشور را پوشش میدهد و از یک نظرسنجی تخصصی با کیفیت از ۱۸۶۲ سوال تکمیل شده توسط ۱۳۸ محقق داخلی بین نوامبر ۲۰۲۳ و فوریه ۲۰۲۴ ساخته شده است. این شاخص، به کشورها در مقیاس ۰ تا ۱۰۰ در حوزههای موضوعی، شامل چارچوبهای دولتی، اقدامات دولتی و نقش جامعه مدنی و سازمانهای حمایتی، امتیاز میدهد. با این حال، توجه به این نکته مهم است که نمرات پایین لزوماً نشان دهنده این نیست که یک کشور بُعد خاصی را نادیده میگیرد. در بسیاری از موارد، آنها منعکس کننده مراحل اولیه استقرار و انتشار هوش مصنوعی یا ظرفیت محدود نهادی برای رسمیسازی چارچوبهای خاص هوش مصنوعی هستند.
بعد حریم خصوصی و حفاظت از دادهها در امتیاز GIRAI بررسی میکند که آیا کشورها قوانینی دارند که نحوه جمعآوری، استفاده و اشتراکگذاری دادههای شخصی در سیستمهای هوش مصنوعی را کنترل کند، و اینکه آیا این قوانین توسط تنظیمکنندههایی با قدرت اجرای آنها پشتیبانی میشوند یا خیر.
کشورها در طیف وسیعی قرار میگیرند، و امتیاز GIRAI در کشورهای مورد بررسی از نزدیک به صفر تا بالای ۸۰ متغیر است (شکل ۳-۱۵).
استرالیا و بخشهایی از اروپا بالاترین امتیاز را دارند، در حالی که بخشهایی از آفریقا و خاورمیانه فقدان قانون اختصاصی حفاظت از دادهها را نشان میدهند. یک نقشه تکمیلی از UNCTAD تأیید میکند که اکثر کشورها اکنون نوعی قانون حفاظت از دادهها را در دست دارند، اگرچه تعداد کمی از آنها، که عمدتاً در آفریقا و بخشهایی از آسیا متمرکز هستند، هنوز در مراحل پیشنویس هستند یا اصلاً قانونی ندارند.
۳-۷ انصاف و تعصب
انصاف و تعصب از جمله ابعاد هوش مصنوعی مسئولانه هستند که اندازهگیری آنها دشوار است، تا حدی به این دلیل که آنچه منصفانه تلقی میشود به شدت به زمینه بستگی دارد. GIRAI کشورها را به طور جداگانه بر اساس تعصب و تبعیض ناعادلانه، برابری جنسیتی و تنوع فرهنگی و زبانی امتیازدهی میکند.
۳-۷-۱ تعصب و تبعیض ناعادلانه
بعد تعصب و تبعیض ناعادلانه از امتیاز GIRAI ارزیابی میکند که آیا کشورها اقدامات صریحی برای جلوگیری و کاهش پیامدهای تبعیضآمیز ناشی از هوش مصنوعی در طراحی، توسعه و استقرار آن دارند یا خیر. این بُعد برای رسیدگی به تعصب الگوریتمی ناشی از دادههای غیرنماینده، طراحی ناقص یا نابرابریهای اجتماعی ریشهدار که میتوانند صرف نظر از نیت به گروههای حاشیهنشین آسیب برسانند، در نظر گرفته شده است. این بُعد بررسی میکند که آیا دولتها قوانین، نهادهای نظارتی و سازوکارهای اجرایی را وضع کردهاند یا خیر و آیا سازمانهای جامعه مدنی به طور مستقل برای نظارت و رسیدگی به تعصب تلاش میکنند یا خیر.
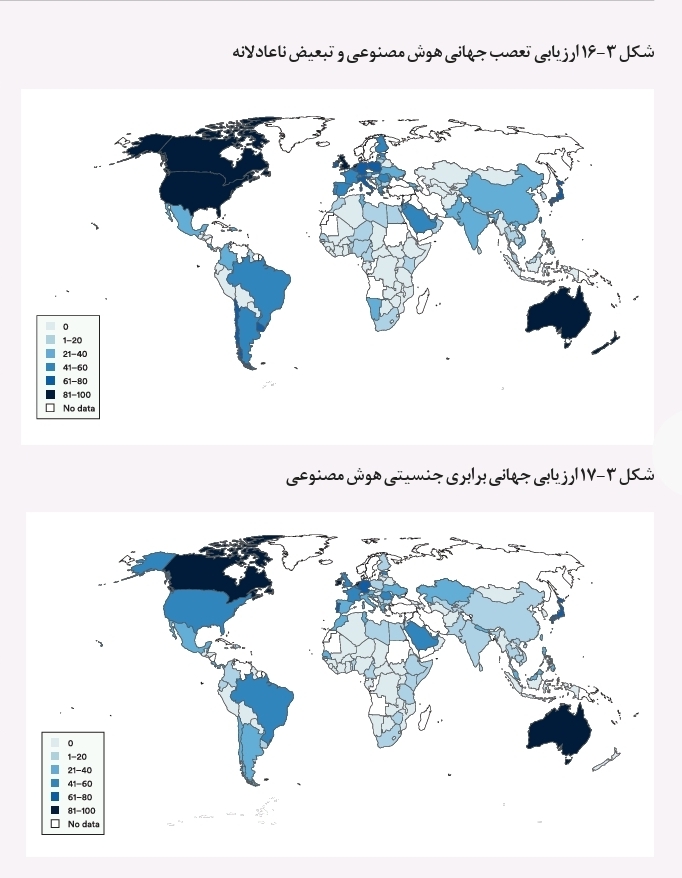
امتیازات GIRAI در این بعد در کل نسبتاً پایین است (شکل ۳-۱۶). ایالات متحده و کانادا بالاترین امتیاز را کسب کردهاند، در حالی که استرالیا، بخشهایی از اروپا و برزیل در محدوده متوسط قرار دارند. بخش عمدهای از آفریقا، خاورمیانه و آسیای مرکزی امتیازی کمتر از ۲۰ کسب کردهاند.
۳-۷-۲ برابری جنسیتی
بُعد برابری جنسیتی GIRAI بررسی میکند که آیا کشورها طرحهای دولتی و غیردولتی دارند که از تعصب جنسیتی جلوگیری کرده و از حقوق برابر برای همه هویتهای جنسیتی در طراحی، توسعه و استفاده از هوش مصنوعی محافظت کند یا خیر. کانادا و هلند بالاترین امتیاز را در این معیار دارند (شکل ۳-۱۷). بخشهایی از اروپا و ژاپن در محدوده ۶۱ تا ۸۰ قرار دارند و پس از آنها کشورهایی مانند ایالات متحده و برزیل قرار دارند که امتیازی بین ۴۱ تا ۶۰ دارند.
۳-۷-۳ تنوع فرهنگی و زبانی
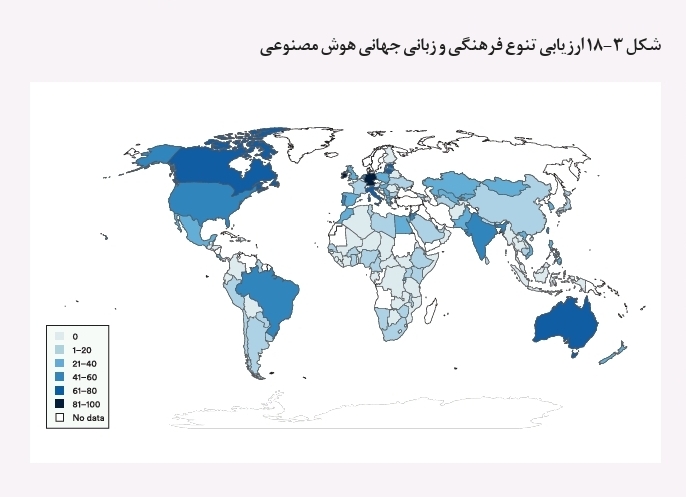
بُعد تنوع فرهنگی و زبانی GIRAI بر اقدامات حفاظتی کشورها در مورد زبانهای محلی، گویشها، سیستمهای دانش بومی و تنوع فرهنگی به طور گسترده در سراسر چرخه حیات هوش مصنوعی تمرکز دارد. فرضیات فرهنگ غالب میتواند هوش مصنوعی را دچار سوگیری کند، اقلیتها را به حاشیه براند و زبانهای اقلیت را از بین ببرد. امتیازات در این بعد به طور مساویتری نسبت به سایر موارد توزیع شده است (شکل ۳-۱۸). سنگاپور بالاترین امتیاز را دارد، در حالی که آلمان، ایرلند، ایتالیا، قطر، استونی و اسلوونی نیز در محدودههای بالاتر (۷۰-۸۸) امتیاز دارند.
همه مناطق به یک شکل از تنوع فرهنگی و زبانی محافظت نمیکنند. در آمریکای شمالی، برنامههای دولتی و بازیگران غیردولتی، مانند گروههای مدافع، مؤسسات تحقیقاتی و سازمانهای حقوق دیجیتال، فعال هستند، اما چارچوبهای قانونی رسمی کمتر توسعه یافتهاند. در اروپا، آسیا و خاورمیانه، بازیگران غیردولتی نیز بیشتر از دولت فعالیت میکنند. در آفریقا، این شکاف به ویژه مشهود است. بازیگران غیردولتی در ۳۹ درصد از کشورها فعالیت نشان میدهند، اما تنها ۷ درصد از آنها برنامههای دولتی و تنها ۲ درصد چارچوبهای قانونی دارند. شفافیت، میزان افشای اطلاعات توسط توسعهدهندگان در مورد نحوه ساخت، آموزش و استقرار مدلهایشان را اندازهگیری میکند. دو شاخص مستقل این موضوع را از زوایای مختلف پیگیری میکنند.
۳-۸ شاخص باز بودن
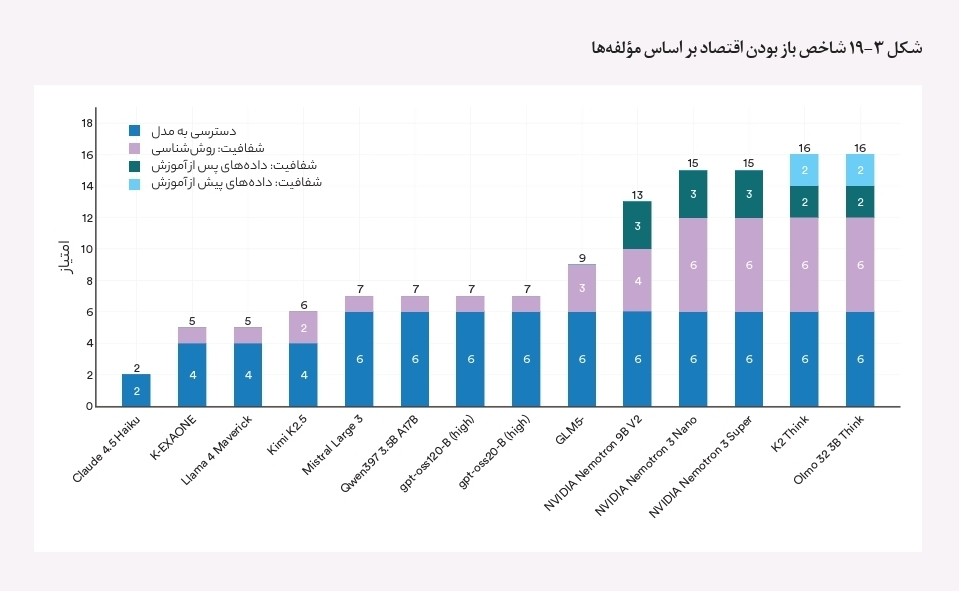
شاخص باز بودن تحلیل مصنوعی، مدلهای هوش مصنوعی را بر اساس میزان دسترسی و مجوزدهی آزادانه به وزنها، و همچنین سطح شفافیت در مورد روش آموزش و دادههای قبل و بعد از آموزش، در مقیاس ۰ تا ۱۰۰ امتیاز میدهد. امتیازها در بین مدلهای پیشرو پایین است و اکثر آنها بین ۲ تا ۱۶ از ۱۰۰ قرار دارند (شکل ۳-۱۹). K2 Think و Olmo 3 32B Think بالاترین امتیاز را کسب کردند و همچنین تنها دو مدلی هستند که امتیازی برای شفافیت دادههای قبل از آموزش کسب کردهاند. هر مدل دیگری در این شاخص در آن دسته امتیاز صفر دارد. دسترسی به مدل و افشای روش، بخش عمدهای از امتیازها را در بین همه مدلها تشکیل میدهند. همانطور که در بحث فصل ۱ در مورد دسترسی و استقرار اشاره شد، بیش از ۹۰٪ از مدلهای صنعتی مهم در سال ۲۰۲۵ بدون کد آموزشی منتشر شدند. نتایج شاخص باز بودن نشان میدهد که الگو فراتر از کد به دادههای آموزشی نیز گسترش مییابد.
۳-۸-۱ شاخص شفافیت مدل بنیادی
شاخص شفافیت مدل بنیادی (FMTI) رویکرد متفاوتی را اتخاذ میکند و به جای مدلهای منفرد، به توسعهدهندگان امتیاز میدهد. اکنون در سومین سال فعالیت خود، افشای اطلاعات را در سه مرحله از چرخه عمر مدل ارزیابی میکند.
بخش بالادستی، آنچه را که در ساخت یک مدل دخیل است، از جمله دادههای آموزشی، نیروی کار و محاسبات، پوشش میدهد.
مدل، آنچه را که در مورد خود سیستم افشا میشود، پوشش میدهد و پاییندست، آنچه را که پس از انتشار اتفاق میافتد، از جمله نظارت و گزارش تأثیر، پوشش میدهد.
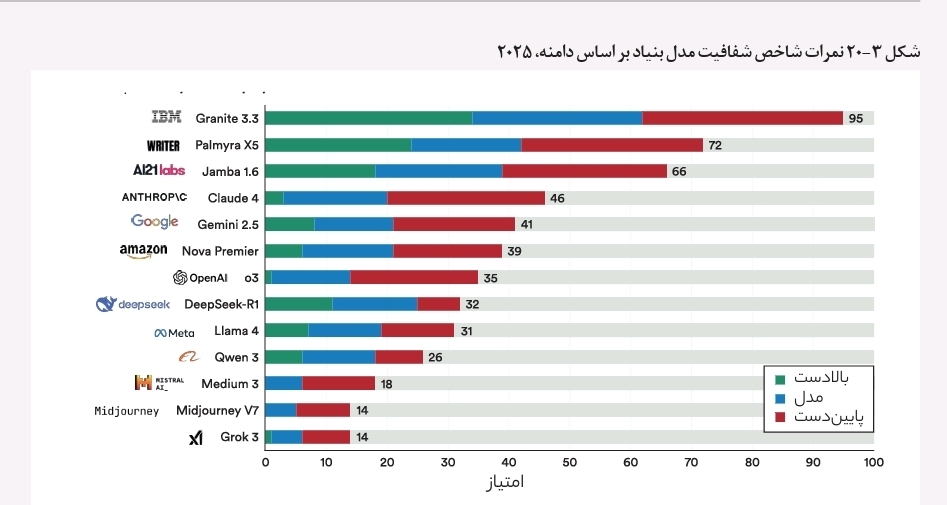
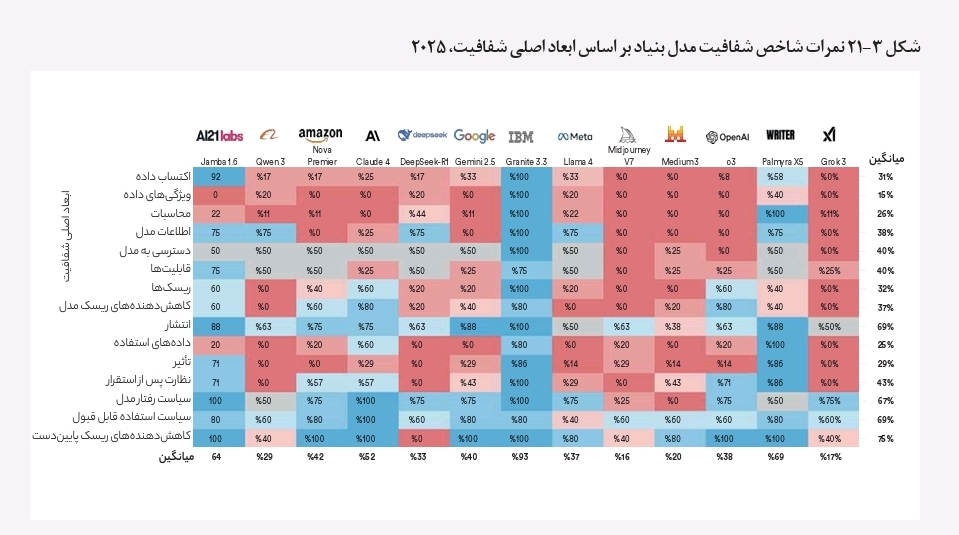
در نسخه ۲۰۲۵، میانگین شفافیت از ۵۸ در سال ۲۰۲۴ به ۴۰ کاهش یافته است (شکل ۳-۲۰). IBM با ۹۵ و Writer با ۷۲ در صدر قرار دارند. دیگران، مانند xAI و Midjourney، تنها ۱۴ امتیاز کسب میکنند، در حالی که توسعهدهندگان مدل باز، ارائهدهندگان سازمانی B2B، سازمانهایی که گزارشهای شفافیت منتشر میکنند و امضاکنندگان قانون هوش مصنوعی اتحادیه اروپا، عملکرد بهتری دارند. همانند شاخص باز بودن، ضعیفترین حوزه، بالادست، به ویژه در مورد دادههای آموزشی و منابع مورد استفاده برای ساخت مدلها است (شکل ۳-۲۱).
۳-۹ امنیت و ایمنی
ایمنی بُعد مسئولیتپذیر هوش مصنوعی است که در آن زیرساختهای نهادی سریعترین رشد را داشتهاند. چارچوبهای ارزیابی جدید، مؤسسات ایمنی هوش مصنوعی تحت حمایت دولت و معیارهای استاندارد، همگی در سال گذشته گسترش یافتهاند. این بخش، این رشد و دادههای حاصل از آن را در مورد چگونگی عملکرد مدلهای فعلی در مدیریت ایمنی در عمل، ردیابی میکند.
۳-۹-۱ مؤسسات جهانی ایمنی هوش مصنوعی
مؤسسات ایمنی هوش مصنوعی (AISI) سازمانهای تخصصی تحت حمایت دولت هستند که برای کمک به دولتها در درک و مدیریت خطرات ناشی از هوش مصنوعی پیشرفته، به ویژه مدلهای مرزی/بنیاد، ایجاد شدهاند. آنها ارزیابیهای فنی و تحقیقات ایمنی را انجام میدهند که دولتها میتوانند از آنها برای شکلدهی سیاست استفاده کنند.
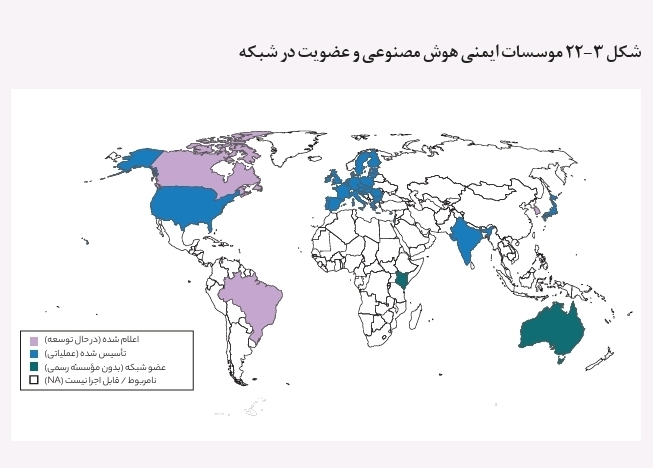
مؤسسات کاملاً عملیاتی اکنون در بریتانیا (مؤسسه امنیت هوش مصنوعی)، ایالات متحده (USAISI در NIST)، ژاپن (JAISI)، سنگاپور (مرکز اعتماد دیجیتال) و اسرائیل (واحد تحقیقات امنیت هوش مصنوعی) وجود دارند (شکل ۳-۲۲). هند و فرانسه نیز AISI راهاندازی کردهاند، با مؤسسه ایمنی هوش مصنوعی هند و مؤسسه هوش مصنوعی فعلی فرانسه. موج دوم در کانادا، کره جنوبی، آلمان و برزیل در حال توسعه است. خارج از این مؤسسات مستقل، مشارکت از طریق شبکه بینالمللی مؤسسات ایمنی هوش مصنوعی در حال افزایش است و کنیا و استرالیا به عنوان اعضای شبکه بدون مؤسسات رسمی خود ذکر شدهاند. کشورهایی که این AISIها را ایجاد میکنند، هنوز عمدتاً اقتصادهای ثروتمند و از نظر فناوری پیشرفتهای هستند که همگی اهداف یکسانی را دنبال نمیکنند. بریتانیا بر امنیت تأکید دارد، در حالی که دفتر هوش مصنوعی اتحادیه اروپا ارزیابی را با اختیارات اجرایی تحت قانون هوش مصنوعی ترکیب میکند. عضویت در شبکه، نقطه ورود عملی برای کشورهایی است که منابع لازم برای تأسیس فوری یک مؤسسه کامل را ندارند.
۳-۹-۲ معیار ایمنی HELM
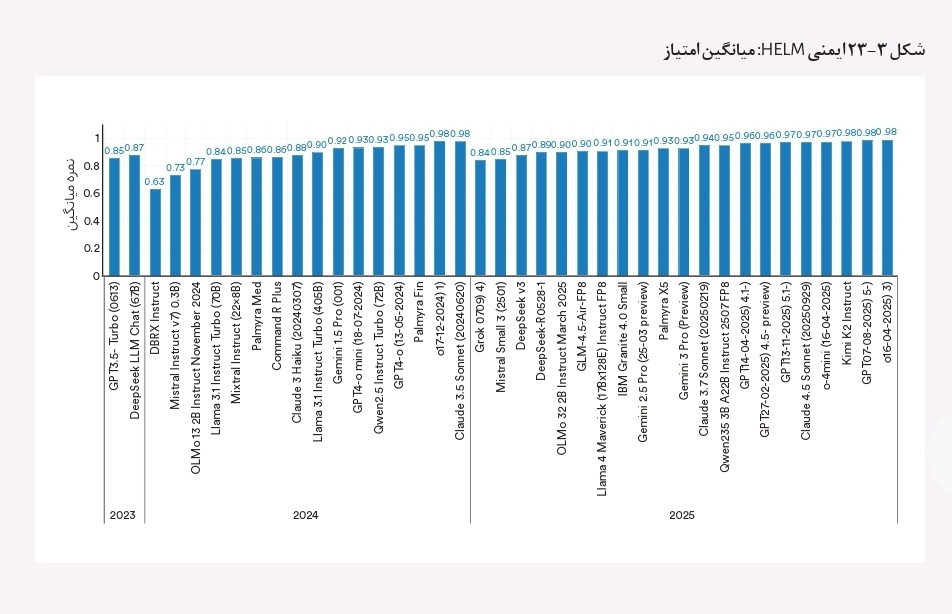
معیار ایمنی HELM که در گزارش سال گذشته پوشش داده شده است، همچنان یکی از معدود مجموعههای استاندارد برای ارزیابی مدلهای هوش مصنوعی بر اساس معیارهای مسئولیتپذیری و ایمنی است. این مجموعه، مدلهای توسعهدهندگان اصلی را در معیارهایی از جمله BBQ (سوگیری اجتماعی)، SimpleSafetyTests (خطرات خودآزاری و سوءاستفاده)، HarmBench (آزار و اذیت و اطلاعات نادرست)، AnthropicRedTeam (گفتوگوهای خصمانه) و XSTest (مبادلههای مفید در مقابل بیضرر) آزمایش میکند. نتایج سال ۲۰۲۵ بهبود مداوم اما همچنین افزایش فشردهسازی در بالا را نشان میدهد (شکل ۳-۲۳). بیشتر مدلهای منتشر شده بین سالهای ۲۰۲۴ و ۲۰۲۵ امتیازی بین ۰.۹۰ تا ۰.۹۸ کسب میکنند، با شکاف بسیار کمی بین بالاترین و پایینترین امتیاز. مدلهای قدیمیتر از سال ۲۰۲۳ امتیاز پایینتری کسب میکنند، اما مسیر کلی نشان میدهد که مدلهای پیشرو در حال نزدیک شدن به سقف ایمنی هستند که در آن معیارهای فعلی ممکن است به اندازه کافی دقیق نباشند تا تفاوتهای معنادار را تشخیص دهند.

دیدگاهتان را بنویسید